从模型部署到能力运营:华山医院AI MaaS平台建设实践
随着生成式人工智能、大语言模型以及智能体技术快速发展,人工智能正在加速融入医疗服务、医学科研和医院运营等领域。医疗AI应用正在从早期的单点应用探索,逐步向医院级AI平台建设演进。如何建设统一的AI算力基础设施、模型服务平台以及智能应用支撑体系,成为医院人工智能规模化落地过程中需要重点解决的问题。
作为国内领先的三级甲等综合医院,复旦大学附属华山医院(以下简称“华山医院”)积累了大量医疗数据资源,同时持续推进医疗数字化建设和人工智能创新探索,围绕医疗大模型应用、科研创新以及智能化服务、临床辅助需求,逐步开展AI能力建设。
在AI应用探索初期,医院通过GPU/NPU服务器资源支持不同团队开展模型验证和应用开发。随着人工智能应用场景不断增加,原有以项目为中心、以服务器为载体的资源建设模式逐渐面临资源分散、重复建设、管理复杂以及服务稳定性不足等问题。为进一步提升医院AI基础设施平台化水平,华山医院此次构建了面向医疗场景的AI模型服务(MaaS)平台,为医疗智能体、大模型应用和科研创新提供统一算力底座支撑平台。
此前,院内AI算力建设普遍采用Ollama、Docker等轻量化工具在单机或科室局部环境中部署开源大模型,形成“一个项目、一套算力资源”的建设模式。各科室与科研团队按需独立申请、分散部署,彼此之间资源不互通、能力不复用,导致同类模型与基础环境重复搭建、算力资源闲置与紧缺并存,整体利用率长期处于低位;同时,算力资源的实际使用情况与模型服务调用量(Token)缺乏可观测手段,处于“部署了哪些模型、谁在用、用了多少、效果如何”的黑盒状态,无法沉淀为可量化的院级数据资产、算力资产。
为此,医院计划将分散的本地模型能力收敛至统一入口,将算力资源与模型服务调用量(Token)明确为全院统一的战略资产,并可围绕其全生命周期建立集中化的管理、使用、分配、计量与管控机制,实现资源可视、用量可查、成本可算、权限可控,构建集模型统一管理、算力统一管理使用、模型服务高可用与资源共享于一体的医院MaaS平台,为后续规模化、规范化的智能应用建设奠定基础。
围绕“打造统一、开放、经济可持续的医院级MaaS平台”的建设目标,医院基于高可用的Kubernetes架构设计了MaaS平台,为大模型、知识库、智能体及未来医疗多模态智能应用提供稳定、可持续演进的AI基础设施支撑。整体落地架构如下:
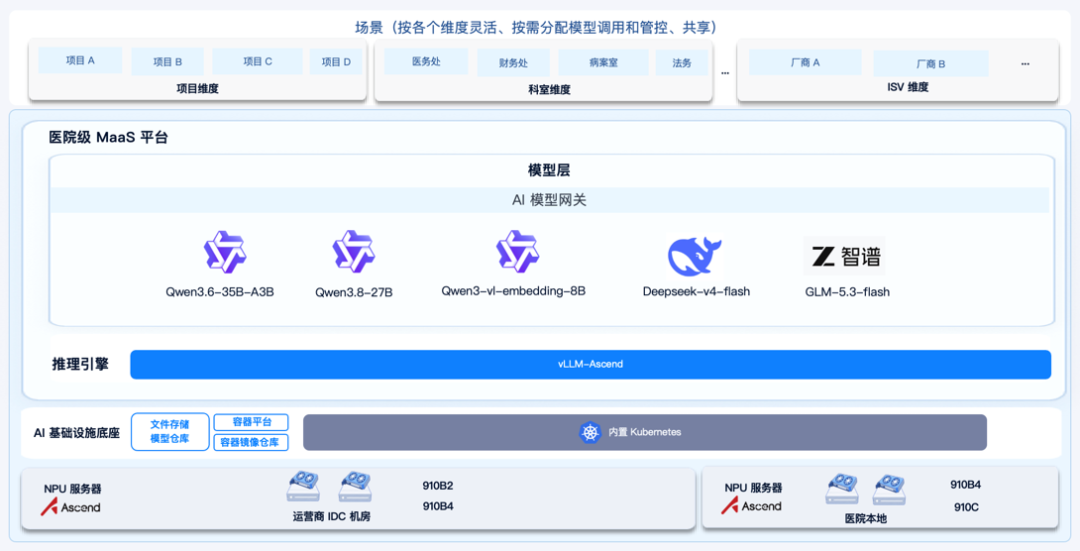
该MaaS平台基于内置的AI基础设施底座(Kubernetes环境),统一纳管多部署位置的昇腾NPU服务器,构建统一算力资源池;同时基于MaaS平台部署vLLM-Ascend推理引擎承载适配的模型服务,并以统一AI模型网关提供服务接入和调用管控。面向不同项目、科室及ISV的业务需求,平台按需配置模型访问权限与调用额度,支持模型资源共享与差异化使用,减少各业务系统重复建设模型运行环境的投入,为医院逐步拓展AI应用提供统一的基础支撑。
1.AI算力资源统一管理
通过MaaS平台,将院内原有分散的GPU/NPU资源进行统一管理。当前接入资源包括位于运营商IDC的昇腾NPU服务器(910B2、910B4),以及位于院内数据中心的910B4、910C算力服务器,从“项目独占算力服务器”转变为建设医院统一的AI算力底座。
2.模型服务快速部署、统一承载、灵活管控
(1)模型服务快速部署,支持新业务快速上线。医院可以根据临床、科研及业务创新需求,灵活部署各类模型,并及时引入最新发布的模型。建设MaaS平台前,新模型部署、上线需要人工准备环境、服务器、环境配置、安装依赖、模型部署、调试服务等多个环节,通常至少需要3周时间。建设MaaS平台后,模型能够通过标准化流程快速部署,实现从模型文件到模型服务接口的快速交付。
目前,从搭建MaaS平台底座到上线模型服务供各科室使用,这个过程仅需约2天时间;后续如需使用新发布的模型,3小时内即可完成部署,快速推进到测试和使用阶段。
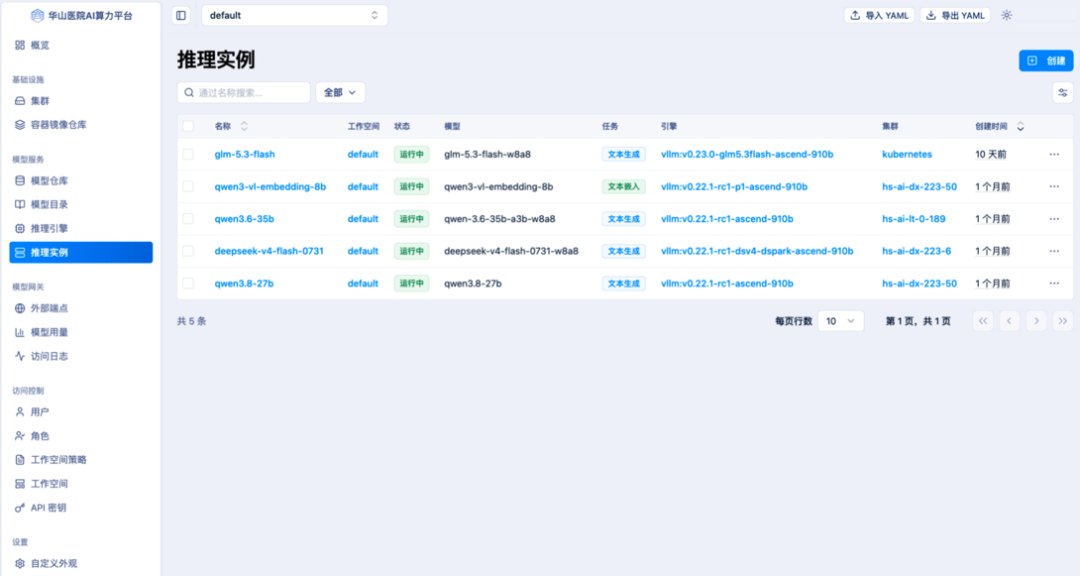
(2)多类模型统一承载,满足多种业务场景需求。目前,MaaS平台可支持多类型大模型部署,包括Qwen系列模型、DeepSeek系列模型、Embedding模型、Rerank模型,可快速实现模型上传、模型服务部署、API开放、应用调用和运行监控。平台也可支持语音ASR模型、OCR模型等小模型,满足语音识别、图像识别等使用场景。院内目前已基于现有算力资源完成Qwen3.8-27B、DeepSeek-v4-Flash、GLM-5.3-Flash、Qwen3.6-35B-A3B等模型的部署。
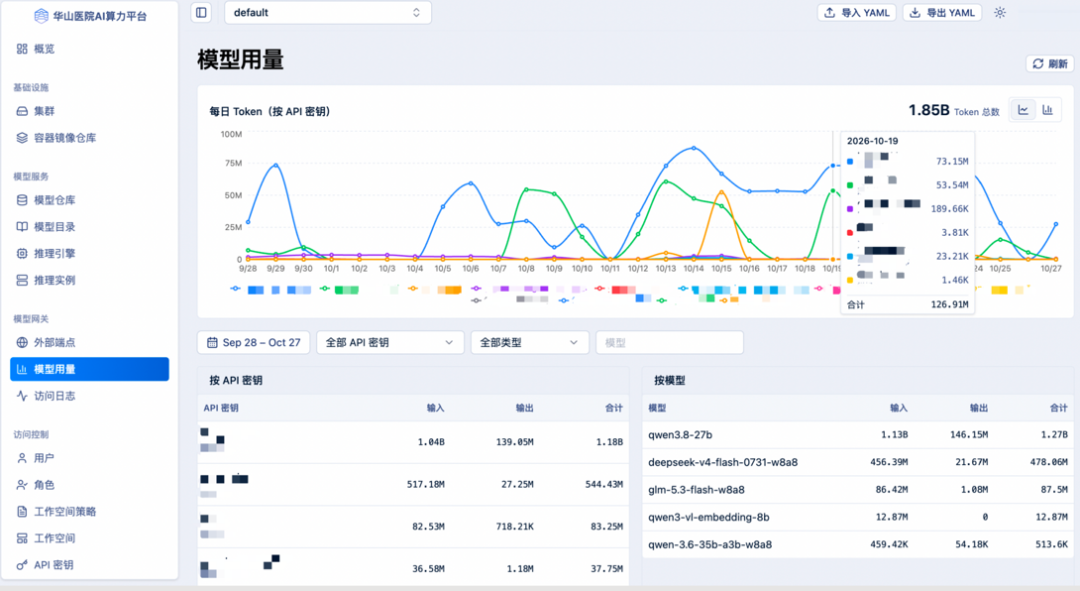
(3)建设统一的模型运营与服务治理平台,让医院的模型服务从“部署上线”真正走向“持续运营”。基于MaaS平台,各科室、科研团队及ISV无需重复建设模型服务,即可通过统一的模型网关按需调用所需能力。与此同时,医院能够对模型调用进行统一管理,实现Token计量、调用配额分配、多租户管理、访问权限控制及服务运行监控,让不同团队的模型使用有额度、调用有记录、资源有边界、运行可追踪。
通过将模型能力统一供给、将模型服务使用纳入规范治理,医院既能持续拥抱快速演进的大模型技术,又能在AI应用不断增多、调用规模持续增长的过程中,实现模型服务的高效复用、精细运营与可持续发展。
3.支撑院内不断增长的各类AI需求和场景
此次构建的医院级MaaS平台,将为医疗知识库、医疗Agent、科研助手等各类上层智能应用统一供给模型能力,形成“底层算力与模型统一管理、上层应用按需调用”的集约化支撑体系。平台采用全栈本地私有化部署,模型推理与数据流转全程运行在院内可控环境中,患者信息、病历数据与科研资料无需离开院内环境即可完成计算,从根本上规避了公有云等模型调用带来的数据外泄与合规风险,满足医疗行业对数据安全、患者隐私保护和监管审计的严格要求。
目前,医院已基于MaaS平台部署的各类模型支持院内多个部门、多个科室、多个项目、多个ISV共享使用。其中,医务处使用模型根据文本内容判断非计划的二次手术;病案室使用模型智能辅助Coding;财务处使用模型比较合同和发票金额是否一致,并核对合同金额相关条款;法务部门结合模型辅助判断合同的合规性;各ISV亦可结合现有模型进行智能问答、辅助诊疗等场景落地。后续也会逐步扩展到更多部门、科室,实现全院平台统一建设、全院资源共享使用。
在建设MaaS平台的过程中,医院也持续从实践中汲取经验,针对模型选型、模型性能等方面进行持续改进与优化。
在MaaS平台建设过程中,模型选型不应单纯追求参数规模或单项性能指标,而应结合医院实际应用场景,综合评估模型的任务处理能力、智能体(Agent)工具调用、代码生成与编程辅助、推理性能及资源开销,形成差异化的模型部署策略。既有部署的各类模型也应为智能体应用、复杂任务处理、知识问答及Coding等场景提供多样化的模型能力。
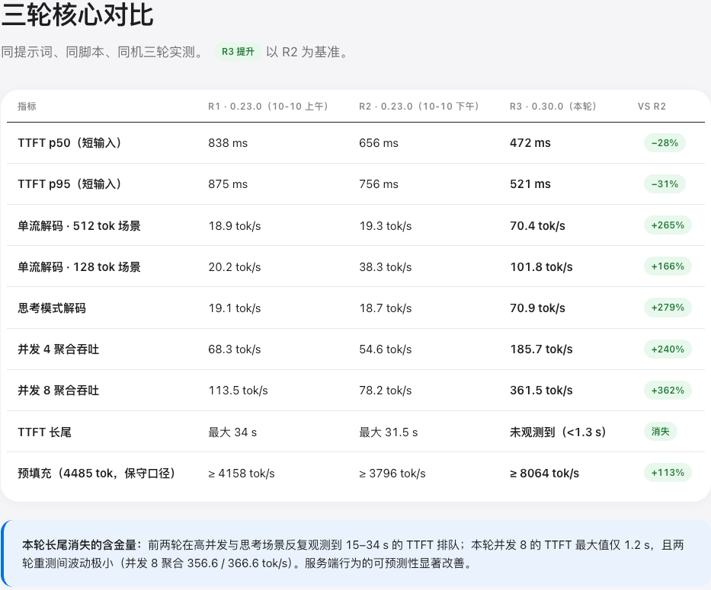
在模型上线与运行过程中,医院信息科也通过实际业务测试,持续关注和评估首Token延迟(TTFT)、生成速度(TPS)、整体吞吐量、请求并发及上下文长度等关键指标,并在AI服务平台厂商的协助下,基于910C芯片调优GLM-5.3-Flash模型的性能表现,实现部分场景约200%的性能提升,单流可稳定达到60~70 tokens/s;三轮对比中不同场景相对第二轮测试结果提升约166%~362%。结合算力资源利用率、KV Cache、请求负载、模型引擎等方面的调优,医院在模型响应效率、并发承载能力与资源利用率之间取得平衡,为模型服务的稳定运行和后续规模化应用积累实践经验。
此次华山医院的院内MaaS平台建设探索了AI基础设施建设的新模式,也为其他三甲医院、医疗集团及区域卫健平台提供了有益的建设思路:以统一AI基础设施底座为起点,以实际医疗业务需求为牵引,统筹算力投入、模型选型、应用落地与安全治理,逐步形成可扩展、可复用、可持续演进的医疗AI能力体系,为智慧医疗建设和医疗服务模式创新、数智化转型奠定基础。