自贡市人工智能协会移动官网
个人中心
搜索
自贡市人工智能协会移动官网
文章详情
副标题
N₀-TWAM深度解读:3万小时视触觉数据落地,触觉正式跻身世界模型核心感知层
2026-09-23
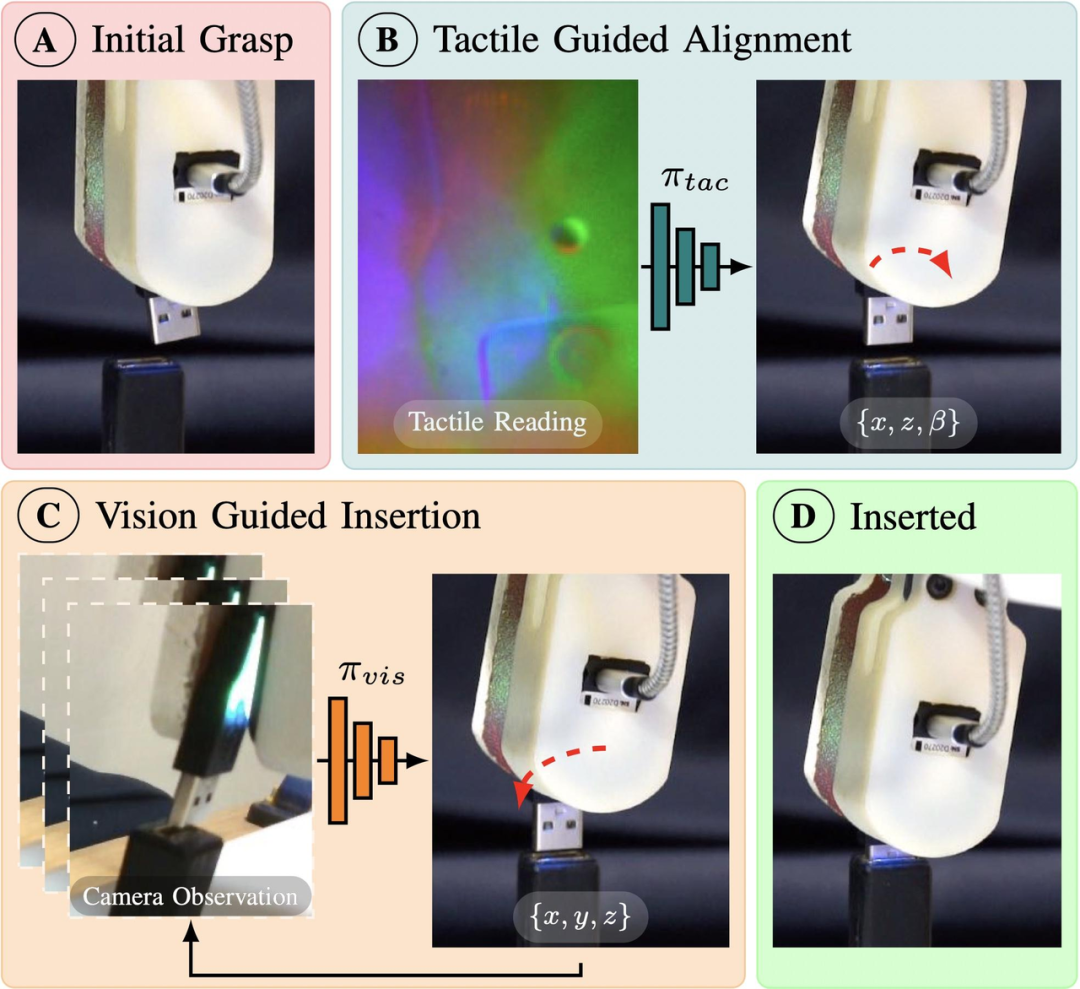
机器人看见插头对准了插座,不代表它知道插头是否卡在边缘;夹爪闭合,也不代表物体真的被夹稳。对人来说,这些判断靠“手感”完成;对长期依赖摄像头的机器人来说,却是最容易失败的“最后一厘米”。
不久前,上海
新智具身NeoteA
I与复旦大学可信
具身智能
团队陆续发布N₀-Foundation、N₀-VTLA和N₀-TWAM三套技术成果。它们不是三篇彼此独立的报告,而是一条完整链路:
先建
设触
觉数据底座,再把触觉接入
VLA
,最后让世界模型同时“想象”未来的画面、接触和动作。
01
触觉为什么一直没有成为主角?
视觉数据便宜、成熟、容易扩展,触觉则恰好相反。不同传感器可能输出凝胶形变图、
电容阵列
或力矩信号,分辨率、单位和结构互不一致;同时,触觉只有在接触发生时才产生高价值信息,大量时段接近“静默”。这使触觉数据难以跨硬件合并,更难用于大规模预训练。
N₀-Foundation试图同时解决“量不够”和“语言不通”。
NeoData包含超过3万小时同步视触觉交互、140万段轨迹、33亿时间步、80亿RGB帧和100亿触觉帧,覆盖手持采集装置及五类机器人平台、450多项任务。公开子集
OpenNeoData
已释放5000多小时、20万多条轨迹,采用LeRobot 3.0格式,覆盖257类任务。
需要注意的是,OpenNeoData采用CC BY-NC-SA 4.0许可,并设置了访问登记,完整数据体量超过9TB。“开源”显著降低了数据冷启动门槛,但不等于存储、清洗、训练和硬件适配成本归零。
更关键的是NeoForce。
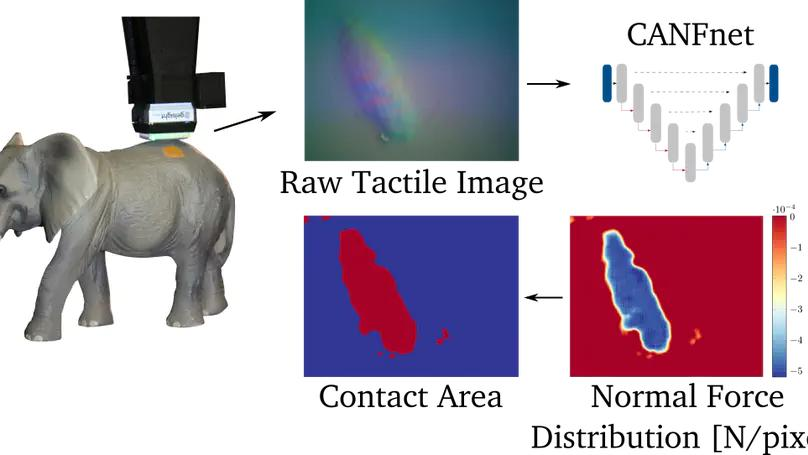
它不强求所有触觉传感器输出同一种原始信号,而是把观测转换为统一的三轴稠密力场:两个切向剪切力分量,加一个法向压力分量。可以把它理解为给不同触觉硬件制定了一套“普通话”——模型关注哪里发生接触、受力多大、是否侧滑,而不是某款传感器特有的像素纹理。
02
N₀-VTLA:从“碰到再反应”变成“碰到前预判”
传统做法通常把当前触觉帧直接拼到视觉输入中。但当前触觉描述的是已经发生的接触,本质上更像后视镜。
N₀-VTLA
改为预测未来一个动作块内的触觉变化,动作跨度为50步:模型根据当前触觉差分、视觉场景和语言指令,生成紧凑的未来
触觉潜变量
,再让动作模块据此规划。测试显示,预测器对正确未来触觉目标的Top-1检索准确率达到92.3%,明显高于只依赖当前触觉编码的57%。
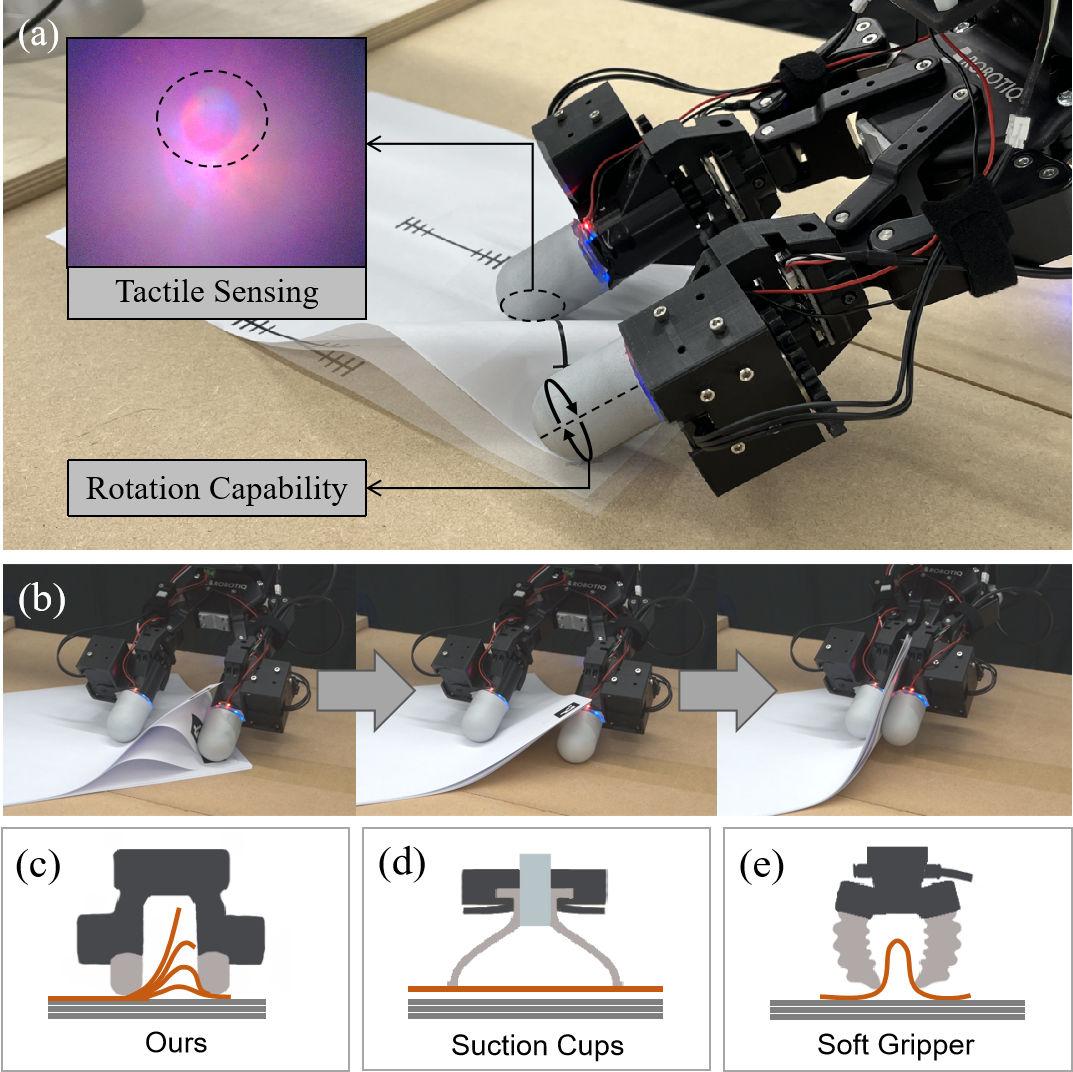
这对插接和柔性物体操作尤其重要。插头略微顶到插座边缘时,画面变化可能很小,压力方向却已经说明“路径不对”;塑料瓶、毛巾或纸箱的形变也可能被夹爪遮挡,但触觉可以暴露夹持过重、滑移或折叠失败。
报告中,N₀-VTLA在真实插座插接任务达到85%成功率,视觉基线为60%;在20项仿真任务上的平均成功率为63.8%,最强总体基线为44.0%。
ALTER离线强化学习还把失败、掉落、人工纠偏和恢复过程转化为训练信号。
加入ALTER后,毛巾折叠、背包装填和纸箱折叠的成功率分别达到95%、80%和75%,说明部署产生的“坏数据”也可以成为模型继续迭代的材料。
03
N₀-TWAM:世界模型第一次把“手感”写进未来
N₀-TWAM的核心变化,不是简单增加一个传感器,而是改变世界模型预测未来的方式。
纯视觉世界模型主要回答:“执行这个动作后,画面会变成什么样?”
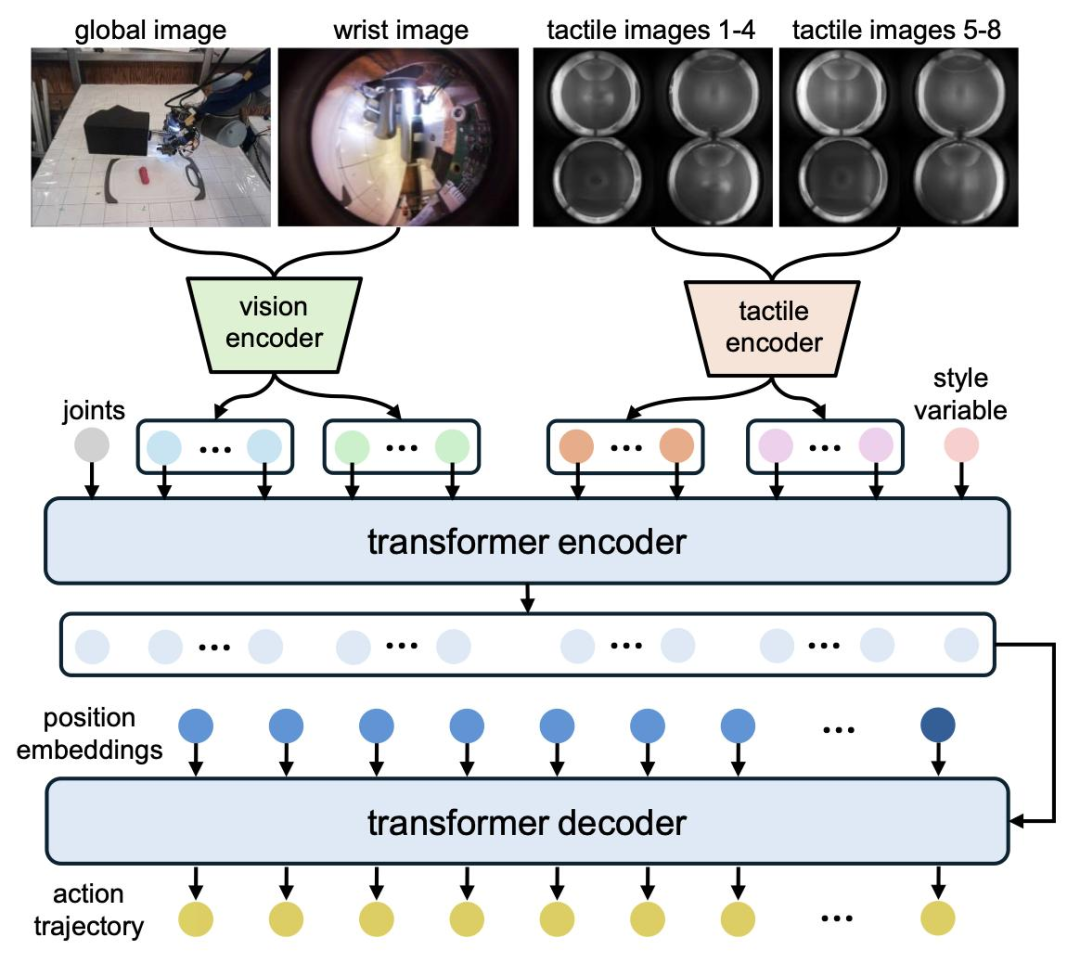
N₀-TWAM则同时推演三个耦合序列:未来视频、未来触觉和动作。
模型先由视频专家与触觉专家共同生成下一段场景和接触状态,再由动作专家基于这组预测结果生成动作。
其非对称Mixture-of-Transformers架构包含约71.6亿个可训练参数:视频专家约50亿,动作与触觉专家分别约11.3亿和10.3亿,通过共享注意力交换信息。推理时缓存视觉和触觉结果,只重复运行较轻的动作专家,以降低实时执行成本。
触觉在模型中有两条通路:预测触觉负责“预见”接触、滑动、受力和释放;当前触觉经过NeoForce力场编码,负责即时纠偏。长任务中,接触开始、夹稳、释放或插入到位还会被当作阶段“标点”,避免机器人只凭语言指令猜测任务进度。
消融结果最能说明问题:完整模型在UniVTAC和NeoSim两套仿真基准上的平均成功率为67.0%;去掉预测触觉后降至56.4%,去掉当前触觉后进一步降至50.0%。在八项真机任务中,
N₀-TWAM平均成功率为46.3%,高于π₀.₅的30.0%和视觉世界动作模型FastWA
M的1
4.4%
。
这里需要说明的是:84.5%是UniVTAC套件成绩,NeoSim平均成绩为49.4%,不能笼统写成“仿真成功率84.5%”。
对比维度
纯视觉世界模型
视触觉世界模型
擅长场景
无接触导航、目标识别、空间移动
插接、抓取、折叠、擦拭、装配
可观测信息
外观、位置、运动趋势
外观+压力、剪切、滑移、接触事件
典型风险
画面合理,但物体未夹稳或已经卡住
传感器、标定和实时融合更复杂
合理路线
自由空间阶段优先使用
接触前后动态启用,形成混合系统
04
它会怎样改变具身智能竞争?
第一,
世界模型不再等同于“机器人视频生成器”
。只预测视觉,容易得到看起来合理、实际上违反接触物理的未来;触觉把摩擦、受力、滑移和形变补进了模型。
第二,
数据工厂出现新的分化方向
。OpenNeoData不能抹平大厂在硬件、算力和真实部署量上的优势,但能让初创团队不必从零搭建触觉采集规范、数据格式和基准测试。冷启动过程有望从“先造基础设施”,缩短为“直接做任务适配”。
第三,
触觉原生世界模型更可能成为灵巧操作底座
,而不是所有机器人任务的统一替代方案。无接触移动仍以视觉为主;一旦进入夹持、插接、装配和柔性物体操作,视触觉融合的价值才会快速放大。
N₀系列真正重要的地方,不只是刷新了数据规模或榜单数字,而是完成了一次路线验证:触觉可以规模化采集,可以形成跨硬件表征,可以进入VLA,更可以成为世界模型预测未来时不可缺失的状态变量。
不过,这些仍是项目团队发布的技术报告结果,后续还需要更多第三方在不同传感器、机器人本体和开放场景中复现。触觉是否会成为具身智能的下一条Scaling Law,答案尚未最终确定;但从这套数据、模型和消融实验看,行业已经很难再把它只当成辅助传感器。
分享
下一篇:
这是最后一篇
上一篇:
这是第一篇
发表评论
登录评论
匿名评论
提交
提交