微软Lens文生图模型开源,训练效率提升5倍,性能碾压6B大模型。
2026-09-23
微软最新开源了一款仅3.8B参数的文生图基础模型——Lens,在多个权威基准上不仅比肩,甚至超越了6B~80B参数的FLUX.1、Qwen-Image、混元3.0等大模型。更惊人的是,它的训练成本仅为Z-Image的19.3%(约19.2万A100 GPU小时),推理速度在单张H100上生成1024²图像仅需3.15秒,蒸馏版Turbo更是0.84秒出图。Lens支持任意1:2~2:1宽高比、最高1440²分辨率,并具备多语言理解能力,全部代码已在GitHub开源。
相关链接
论文:https://arxiv.org/abs/2605.21573 代码:https://github.com/microsoft/Lens 模型:https://huggingface.co/microsoft/Lens
论文介绍
本文聚焦文生图模型的训练效率优化,提出轻量化基础模型 Lens。研究摒弃 “扩大参数量” 的常规路线,从数据质量与模型架构两大维度提升训练效率。团队构建拥有超长语义标注的 Lens-800M 数据集,并创新混合分辨率训练方式;搭配语义 VAE 与高性能语言编码器,加速模型收敛。模型完成预训练后,依次引入强化学习、提示词推理模块与蒸馏加速技术,迭代出多个版本。实测显示,3.8B 参数的 Lens 综合表现对标 6B + 主流模型,训练算力大幅缩减,同时支持多语言、高分辨率与灵活长宽比,为低成本部署文生图模型提供了全新解决方案。
方法概述
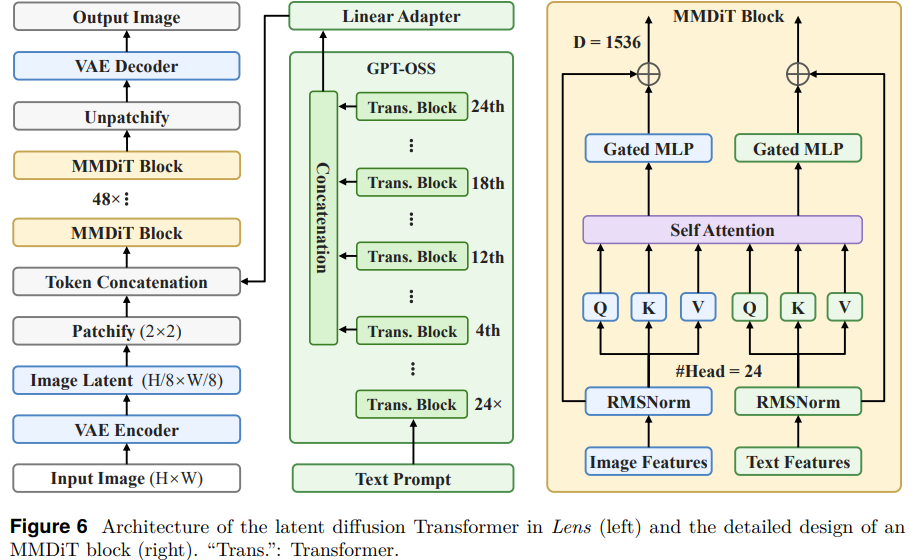
核心训练思路 Lens 核心围绕提升单批次数据信息密度与加快模型收敛速度两大方向优化,区别于单纯堆叠参数与数据的传统方案,从根源降低算力消耗。 数据方案:Lens-800M 数据集 数据集包含 8 亿组图文对,所有标注由 GPT-4.1 生成,单条描述平均达 109 个单词,包含物体、动作、空间关系等丰富语义,远优于传统短标签。训练阶段采用混合分辨率 + 多样长宽比策略,让模型学习多尺度视觉特征,天然适配 1:2 至 2:1 的任意比例图像生成。 模型架构 主体采用潜扩散 Transformer 架构,选用表现力更强的语义 VAE,生成质量更高的隐空间特征;语言端基于 GPT-OSS 编码器,融合多层特征,仅使用英文训练即可实现多语言泛化,进一步强化指令理解能力。 后置优化方案 强化学习(Lens-RL-8K):依托分类学提示词与结构化奖励规则,抑制画面伪影,提升生成画质; 推理增强模块:搭载无训练提示词搜索的推理器,自动优化用户指令,对齐生成需求; 模型蒸馏:推出 Lens-Turbo 极速版,将生成步数压缩至 4 步,大幅提升推理速度。 版本划分 项目共推出三个版本:基础版 Lens-Base、强化学习优化版 Lens-RL、蒸馏加速版 Lens-Turbo,分别适配基础研发、画质优先、高速推理三类使用场景。
实验结果
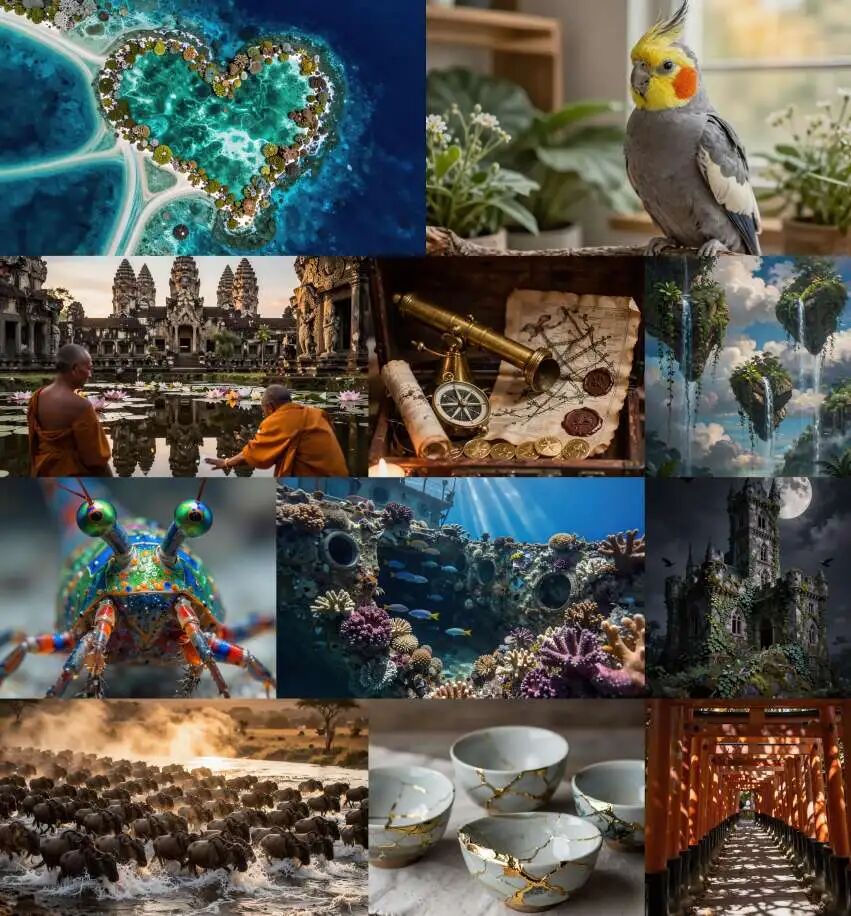
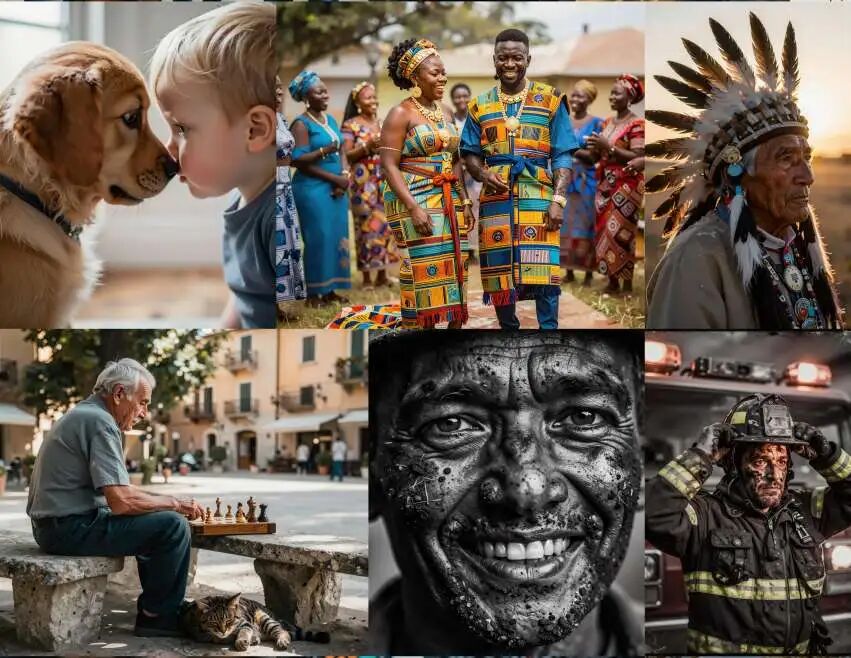
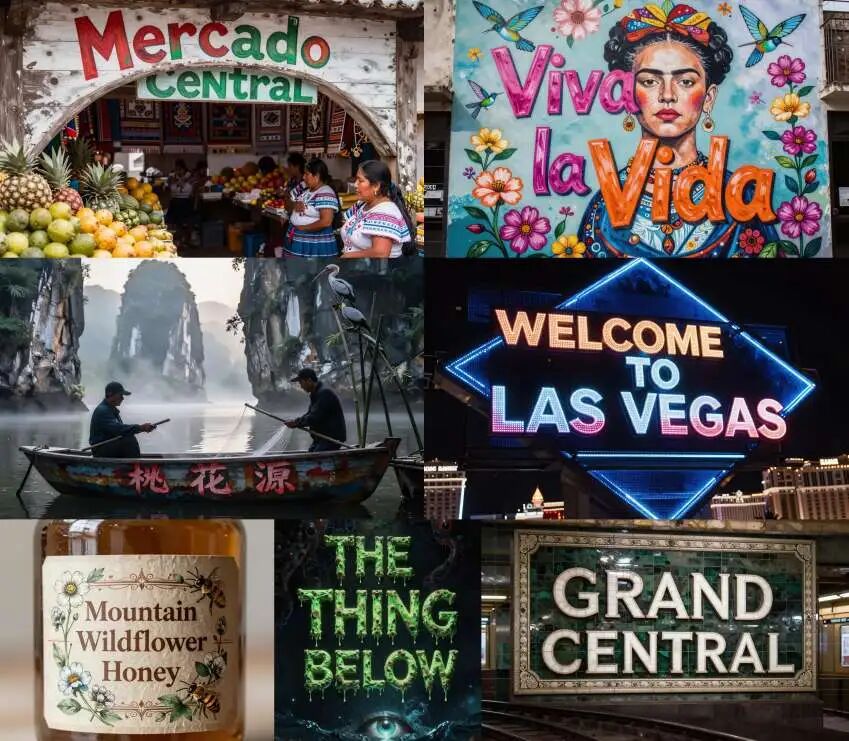
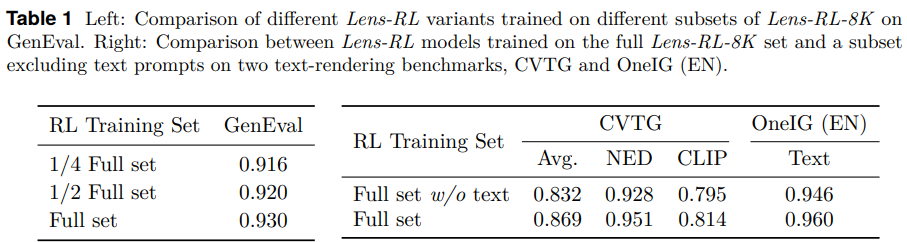
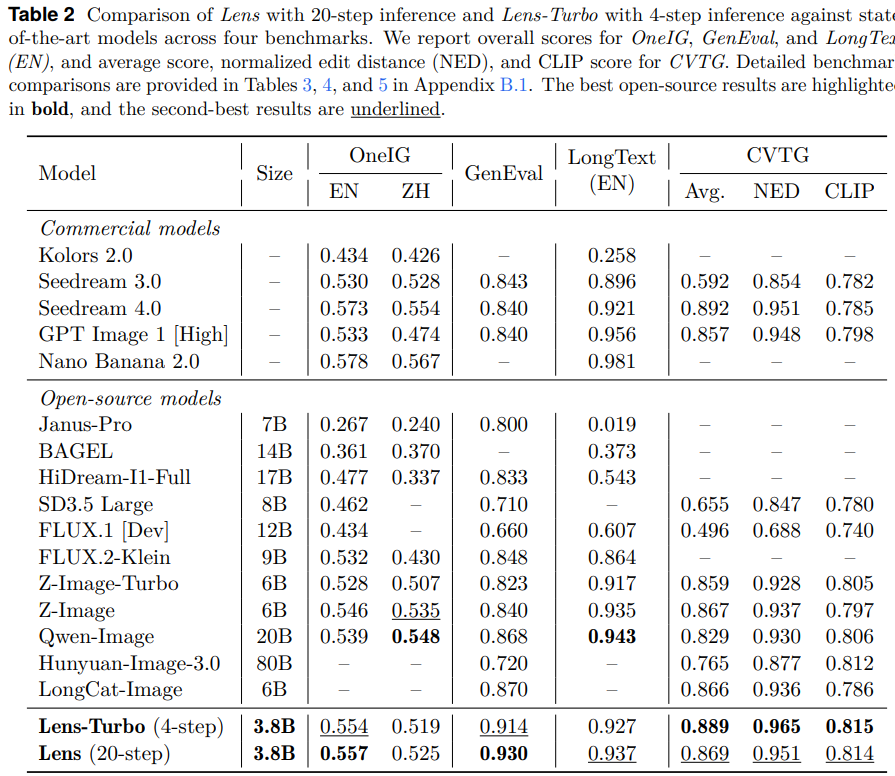
性能表现:在 GenEval 等主流基准中,Lens 得分超越 20B 参数的 Qwen-Image、80B 参数混元 3.0 等大模型,在物体组合、文字渲染等任务上优势明显。 算力对比:训练算力仅为 Z-Image 的 19.3%,算力成本大幅降低。 推理速度:单张 NVIDIA H100 显卡上,标准版生成 1024 分辨率图像耗时 3.15 秒;蒸馏极速版仅需 0.84 秒,推理效率大幅提升。 泛化能力:原生支持最高 1440 分辨率图像,兼容多种长宽比,且具备优秀的多语言指令理解能力。
结论
Lens 模型拥有 38 亿个参数,旨在提高训练效率。Lens 通过在提出的 Lens-800M 数据集上进行密集字幕和混合分辨率/宽高比预训练来提高数据信息密度,并通过精心选择的 VAE 和语言编码器设计来加速收敛,从而在显著降低训练成本的同时实现了高质量的生成结果。大量实验表明,Lens 的性能与规模更大的最先进模型相当,并且在某些情况下甚至超越了它们,同时还能实现快速推理,这表明高效的训练策略可以显著提高基础型 T2I 模型的可扩展性。
下一篇:这是最后一篇
上一篇:这是第一篇