港中文&字节提出 DreamOmni3:用涂鸦+图文输入,让多模态生成编辑听话起来。
2026-09-23
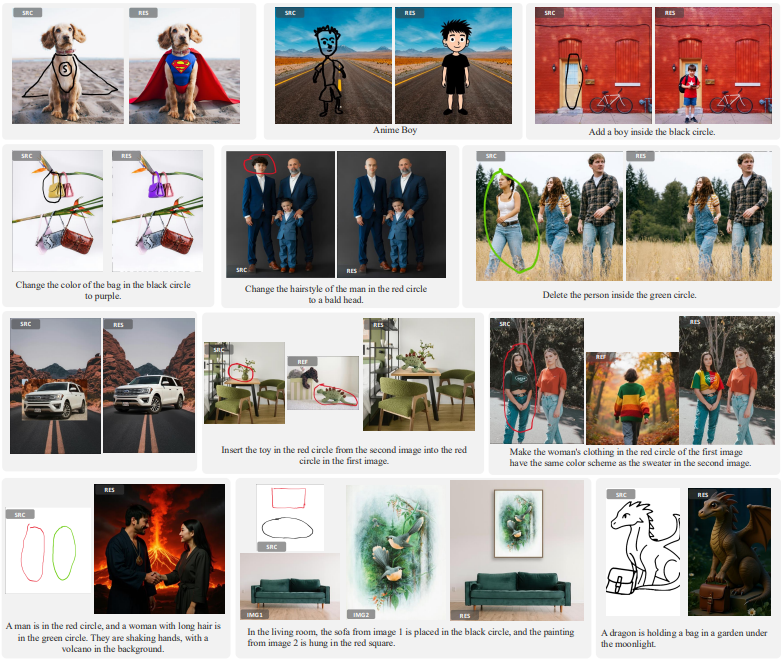
在人工智能飞速发展的当下,多模态生成与编辑领域成绩斐然,统一生成与编辑模型凭借文本指令就能生成精彩内容,展现出强大性能。然而,语言在精准定位编辑区域、捕捉视觉细节方面存在天然短板,难以满足创作者日益精细的需求。在此背景下,港中文与字节联合推出的 DreamOmni3 惊艳亮相。它创新性地解锁“涂鸦 + 图文”联合输入模式,直面数据创建与框架设计难题,为多模态生成与编辑带来了全新思路,有望开启这一领域更为精彩的篇章。
相关链接
论文:https://arxiv.org/pdf/2512.22525 项目:https://github.com/dvlab-research/DreamOmni3(coming soon...)
介绍
近期,统一生成与编辑模型凭借文本指令展现出卓越性能,但语言难以精准定位编辑区域与捕捉视觉细节。为此,研究提出涂鸦式编辑与生成任务,借助图形用户界面融合文本、图像与自由涂鸦,实现更灵活创作,并推出 DreamOmni3 应对数据创建与框架设计两大挑战。其数据合成管道涵盖涂鸦编辑与生成,定义多项细分任务,基于 DreamOmni2 数据集构建训练数据。框架设计上,摒弃易受多涂鸦、图像与指令影响的二元掩码,采用联合输入方案,将原始与涂鸦图像输入模型,通过颜色区分区域、统一编码定位,实现精准编辑。实验表明 DreamOmni3 表现出色,模型与代码将开源。
方法概述
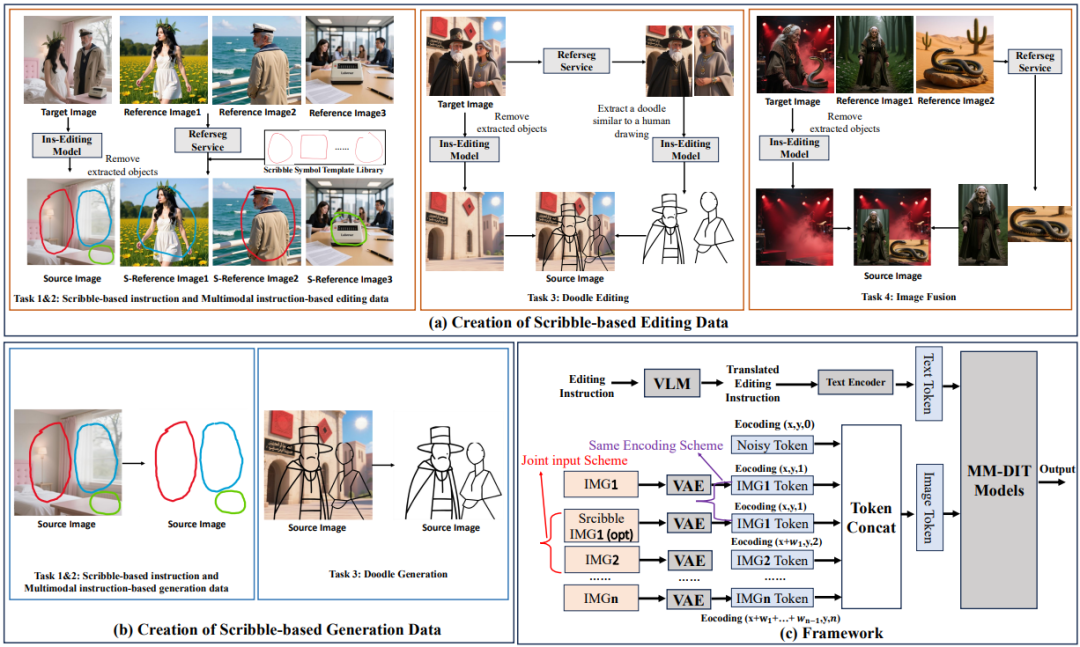 DreamOmni3训练数据构建及框架概述。DreamOmni3训练数据构建及框架概述:
(a) 论文创建基于涂鸦的编辑训练数据。对于涂鸦和多模态指令式编辑,使用Referseg定位编辑对象,并将相应的涂鸦粘贴到源图像和参考图像上,从而创建训练对。对于涂鸦和指令式编辑,省略参考图像。对于涂鸦式编辑,我们使用专用模型将编辑对象转换为抽象草图,并将其粘贴回源图像。对于图像融合,从参考图像中裁剪对象,并将其粘贴到源图像的相应位置,从而构建训练对。 (b) 基于涂鸦的生成训练数据创建方式与编辑类似,只是源图像被替换为空白画布。 (c) DreamOmni3基于DreamOmni2的框架,引入了涂鸦输入的联合输入方案。还对源图像和涂鸦图像应用了相同的编码方案,从而确保更好的像素对齐,并与之前的图像和语言指令编辑完全兼容。
实验结果
下一篇:这是最后一篇
上一篇:这是第一篇