海报文字总排错位?商汤开源SenseNova-U1.5,理解生成一套架构全包,原生4K直出,Apache-2.0可商用。
一个模型同时干理解和生成,还不许带视觉编码器和 VAE?商汤科技推出SenseNova-U1.5,8B-MoT 原生统一多模态模型——8.2B理解参数加 8.2B 生成参数共享 42 层 Transformer,原生分辨率直出 4096×4096,GenEval 总分 0.92 居开源最佳。
SenseNova-U1.5-8B-MoT 是一个原生的统一多模态权重,面向更准确、更一致、更可靠且更具审美表现力的视觉创作。基于 NEO-unify,我们进一步强化了 patchify 层、数据质量与分布、任务定义、Prompt 增强和后训练流程。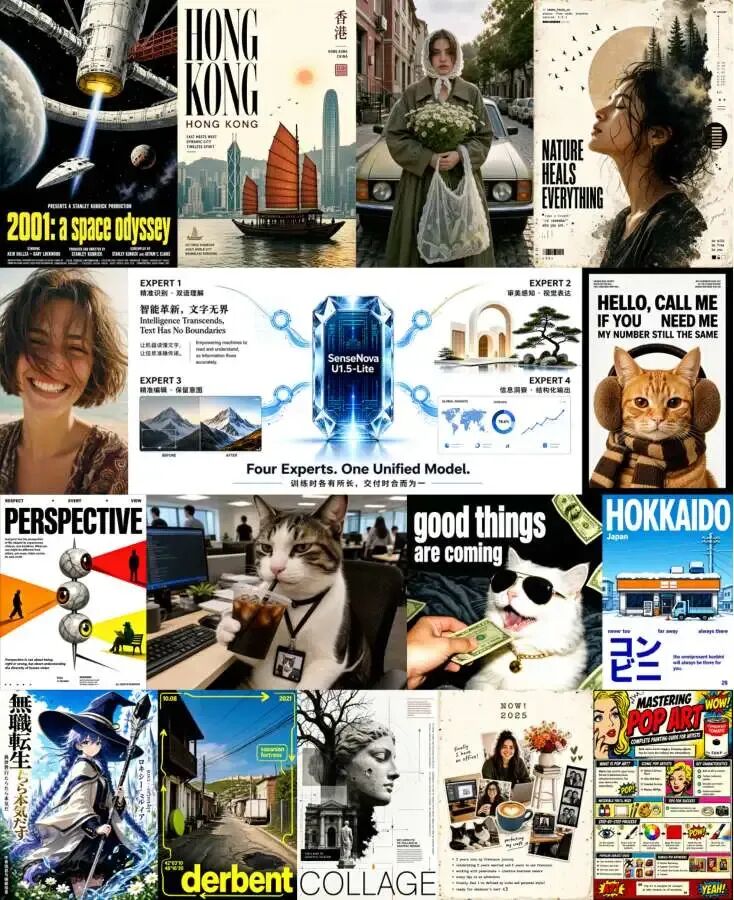
文本到图像生成效果,注意文字渲染与细节还原。
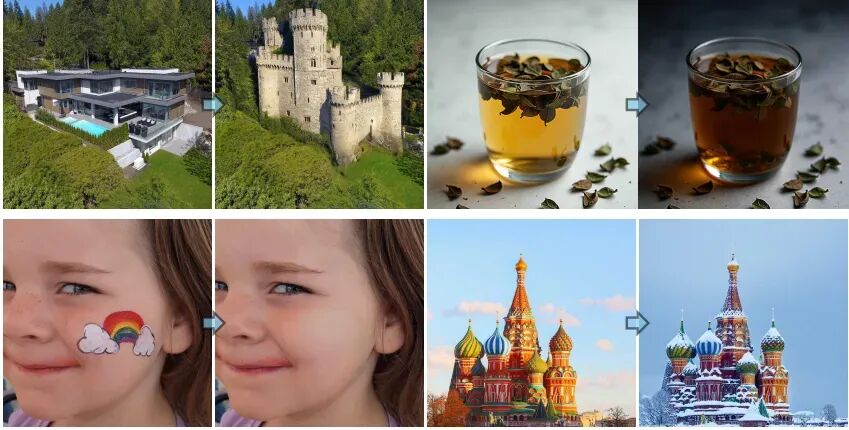
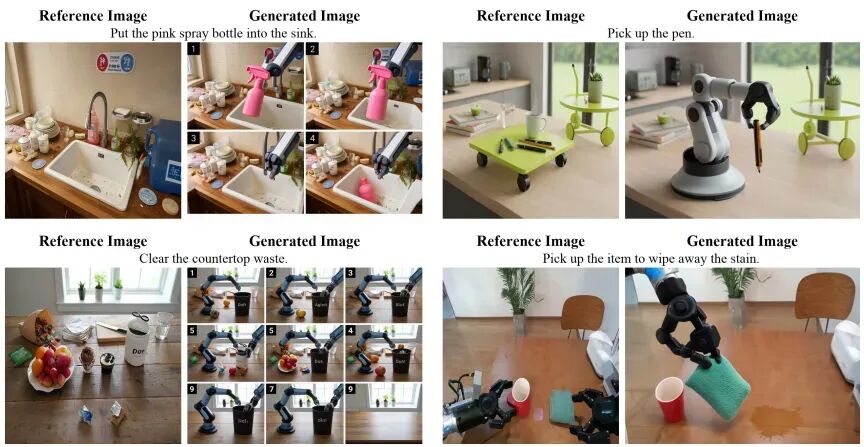
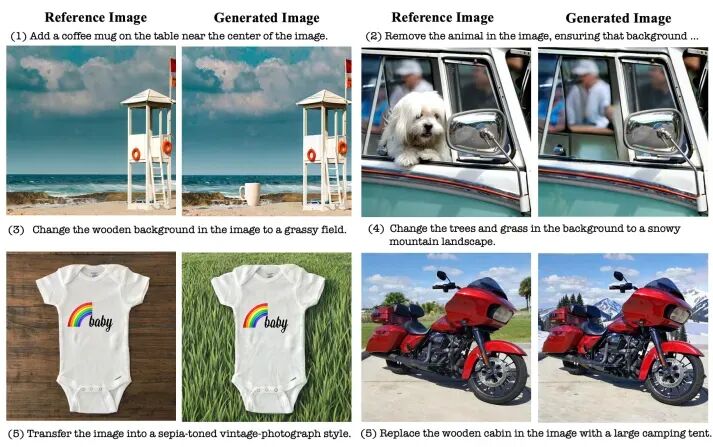
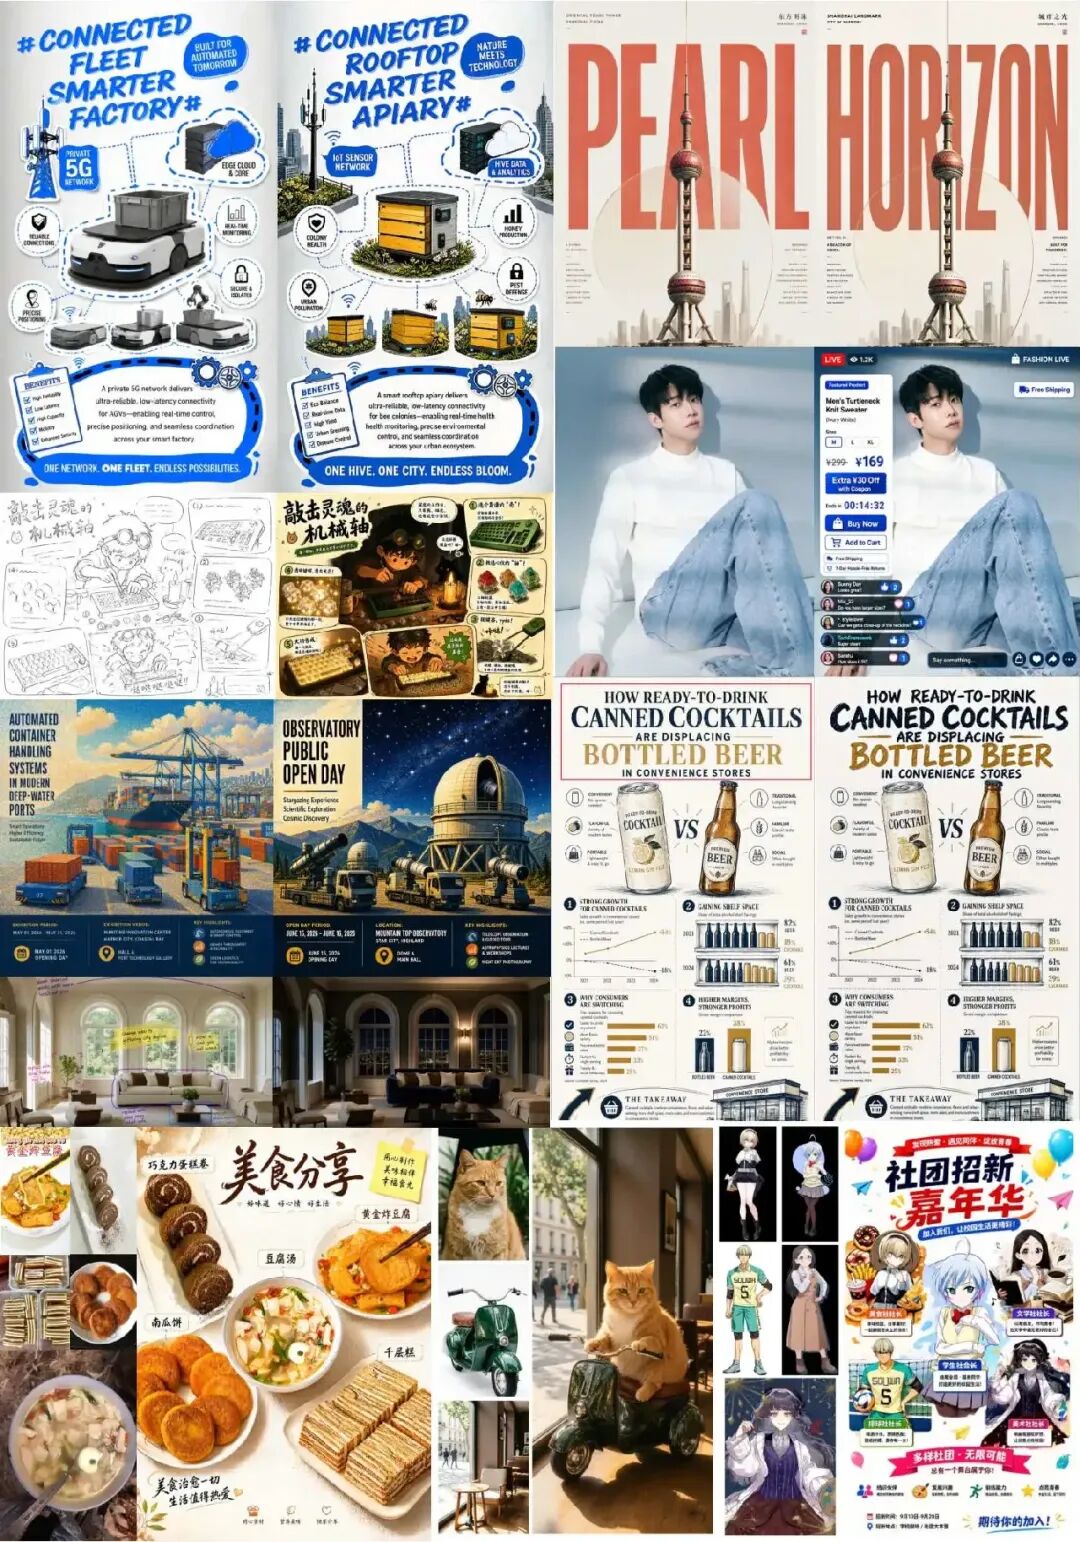 图2:图像编辑效果示例
局部替换、多参考插入等编辑任务的表现,重点观察未编辑区域的保持。
六项能力提升:
更高质量的图像生成: 提升构图、色彩和谐度、材质渲染、光照、真实感与细粒度细节。 更好的文字渲染与信息图生成: 提升中英文文字可读性,并在海报、信息图、品牌素材及其他文字密集设计中呈现更清晰的信息层级。 更高效的原生 4K 生成: 提升全局结构连贯性、高分辨率输出稳定性与生成效率。 更可靠的原生图像编辑: 在局部编辑、文字编辑、多参考图编辑、插入与替换等任务中,更好地保持主体身份与非编辑内容。 更强的复杂指令遵循: 更稳定地执行对象数量、空间关系、版式、风格及单个请求中的多项约束。 更精确的视觉控制: 通过边界框、视觉标记以及单图或多图参考,实现更准确的区域级与对象级控制。
相关链接
论文:https://arxiv.org/abs/2609.11929 代码:https://github.com/OpenSenseNova/SenseNova-U1 模型权重:https://huggingface.co/sensenova/SenseNova-U1.5-8B-MoT 项目主页:https://github.com/OpenSenseNova/SenseNova-U1(NEO-unify架构说明:https://huggingface.co/blog/sensenova/neo-unify ) 开源协议:Apache-2.0
内容介绍
SenseNova-U1.5是一个把多模态理解、推理、图像生成与图像编辑装进单一Transformer的8B-MoT模型:文本、图像、编辑指令进去,理解回答或4096×4096图像出来,中间没有编码器,也没有VAE。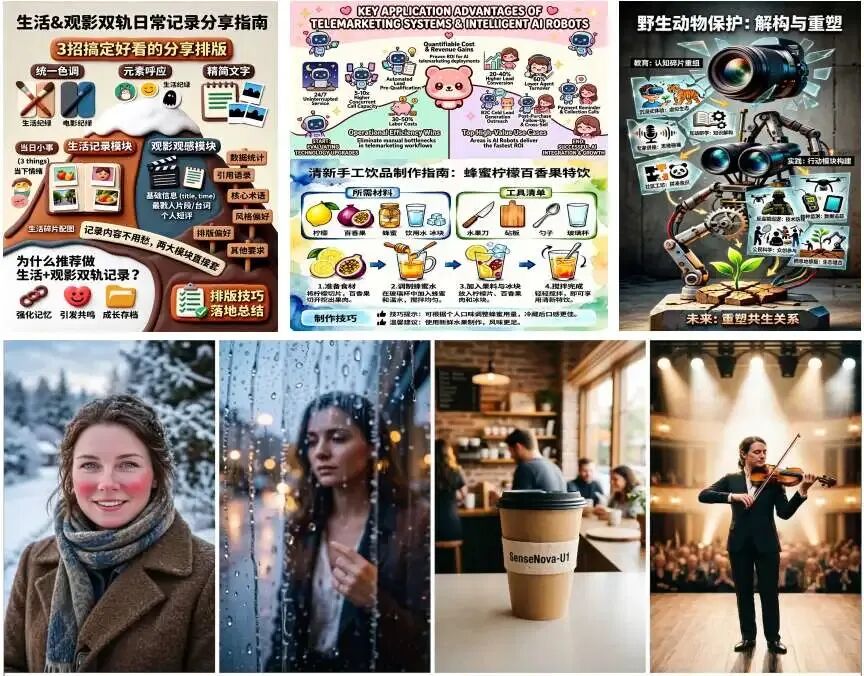
与常见的"理解模型+生成模型拼接"方案不同,它的核心特点是:
encoder-free与VAE-free:32×32像素区域直接压缩为1个视觉token进入主干,像素信息与词元在同一个表示空间里交互; 原生4K生成:分辨率依赖的噪声尺度嵌入将参考分辨率校准到4096²,高分辨率输出不再依赖放大器; 可靠的原生编辑:局部、文字、多参考、插入、替换五类编辑,强调保留主体身份与未编辑区域。
适用场景:海报与信息图直出、电商多参考图编辑、高分辨率物料生成、双语图文渲染,以及需要理解与生成互相反哺的研究场景。
方法概述
一句话概括:一套MoT主干管理解与生成,一个空间解码器管像素质量,一支专家舰队管短板补齐。
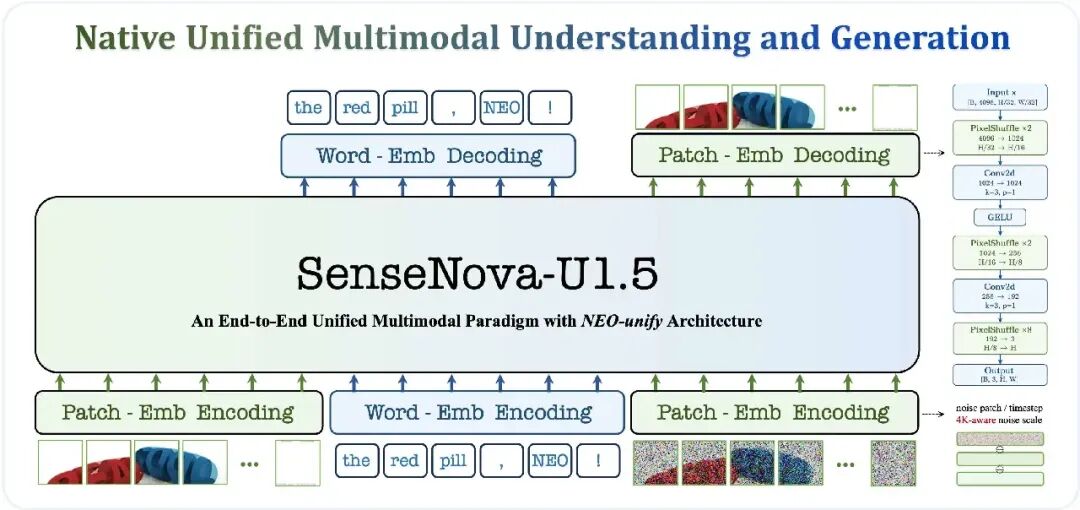 图3:NEO-unify整体架构
词元与像素patch共享同一套双向编解码,右侧为PixelShuffle×2/×2/×8加3×3卷积的空间耦合像素解码器。
1. 空间耦合patch解码(替代独立MLP头)
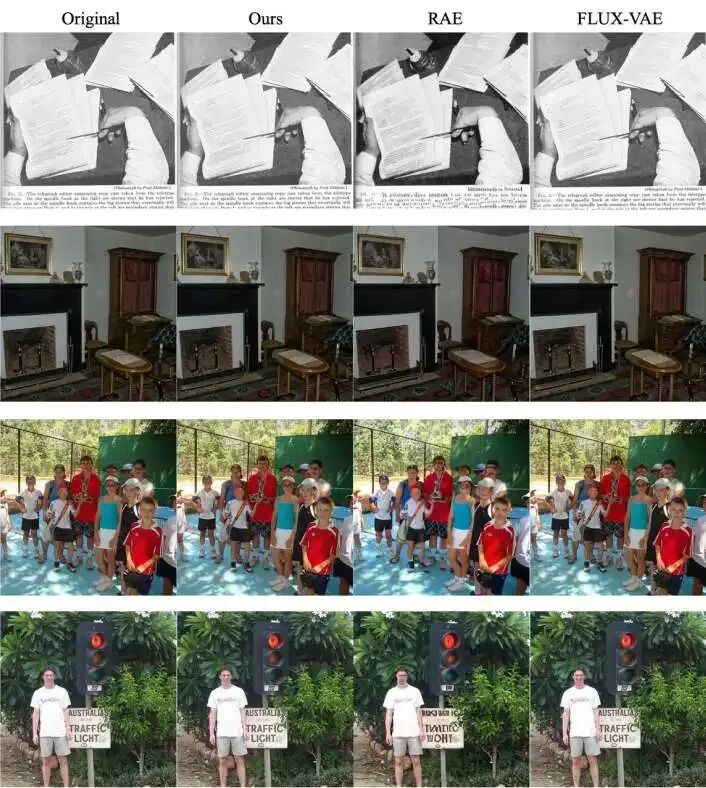
U1的做法是用MLP头独立解码每个32×32视觉token,论文指出这种逐patch分解"在分辨率升高时接缝、纹理不连续和几何不一致会被放大"。U1.5换上轻量空间耦合解码器:先把主干隐状态恢复为二维拓扑,再经PixelShuffle×2、×2、×8三级上采样逐级重建RGB,级间插入3×3卷积让相邻token交换信息——patch边界附近的像素由相邻区域联合决定,而不是各自为政。这也是"网格伪影"被压制的关键。
2. 原生4K与分辨率感知噪声条件
扩散训练中的噪声尺度需要随分辨率校准。U1只校准到2048²,U1.5将参考分辨率扩展到4096×4096,噪声尺度按σ̄R=σR(H,W)/σmax归一化。训练分辨率分阶段推进:第一阶段256²–1024²,后续阶段512²–4096²;59M文生图对中64.4%超过2048²,高分辨率数据占了绝对主力。
3. 四专家RL与多专家在策略蒸馏(MOPD)
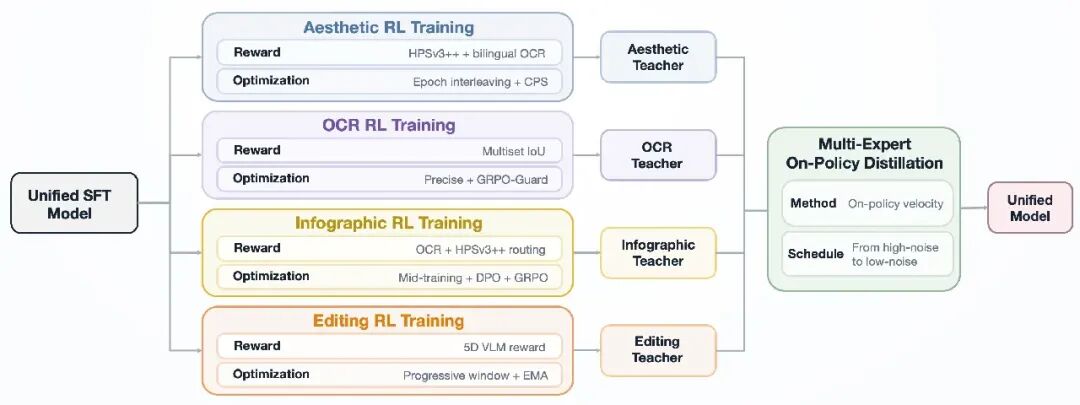 四个专属RL专家分别针对美学、文字渲染、信息图与编辑训练,再经多专家在策略蒸馏合并回统一模型。单模型同时优化四类目标容易互相打架,团队选择分而治之:美学专家(HPSv3++奖励加双语OCR分路由)、OCR专家(PaddleOCR多集合IoU奖励)、编辑专家(指令/执行/质量/文本/保留五维奖励取最小值)、信息图专家(OCR奖励预热→DPO→GRPO三阶段)。随后用800步在策略蒸馏(OPD)把四个专家合并回统一模型,蒸馏期间冻结理解分支、最后3个生成层与输出头,避免破坏已有能力。
实验结果
文生图定量评测
| 0.92 | ||
| 0.948 | ||
GenEval细项里,单物体计数1.00、双物体0.97、计数0.93、颜色0.92、位置0.92、属性0.81。
提示增强(PE)前后的落差
这张表是实际使用时最该看的:同一个模型,裸用和带Prompt Enhancer是两个水平。
| 60.22 | ||
| 88.4 | ||
| 72.0 | ||
| 0.71 |
知识维度从4.8跳到72.0,说明模型本身的知识渲染能力有限,相当一部分表现是提示增强托起来的。
与闭源系统的差距
IGenBench信息图任务上,U1.5(带PE)的I-ACC为0.17,闭源的Nano-Banana-Pro达到0.49——论文自己也承认"与最强的专有系统仍有差距"。
理解端
MMMU 73.86、MathVista 85.85、OCRBench 82.46、C-Eval 90.41,理解能力与生成能力没有因为统一架构而互相拖累。
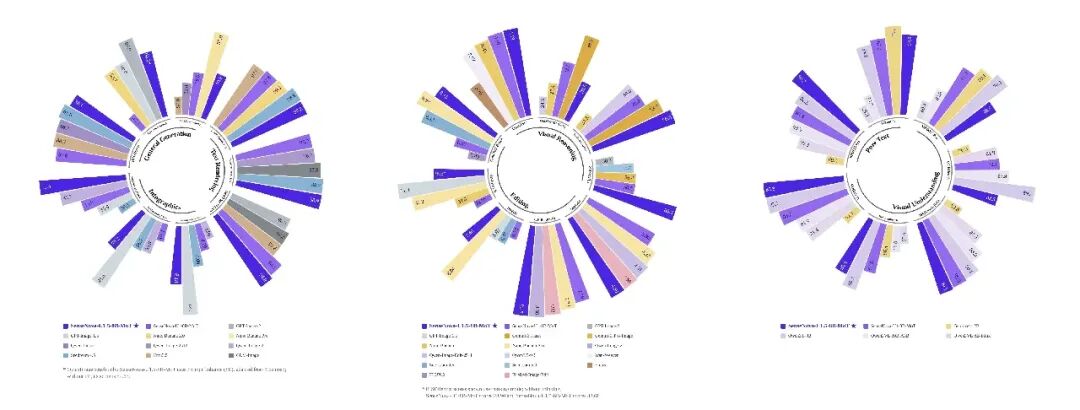 图5:多benchmark性能总览
SenseNova-U1.5在文本渲染、复杂构图、编辑等维度的开源与闭源对比。
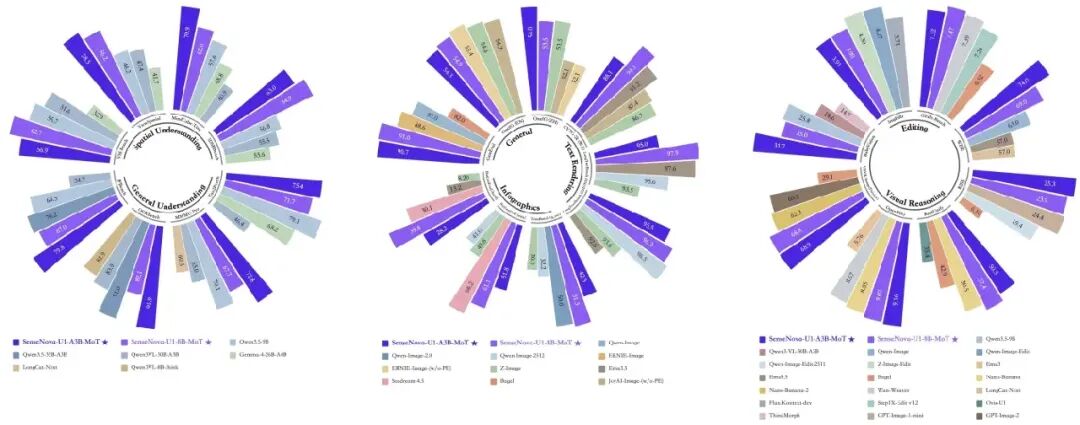 图6:多维度雷达图对比
U1.5与主流开源、闭源模型在多个评测维度上的相对位置(GitHub README)。
结论
SenseNova-U1.5把"理解与生成共享一套权重"这条路线推到了开源第一梯队:GenEval 0.92、CVTG-2K 0.948、原生4K,加上Apache-2.0,工程完成度在开源统一模型里相当少见。
对于个人爱好者,可以先等U1.5-Lite GGUF量化放出,或用社区Q8量化(21.2GB)加24GB显卡体验;对于开发者,生产部署官方推荐LightLLM+LightX2V栈,H100/H200上2048²约9秒出图;对于算法研究者,空间耦合解码与四专家蒸馏的消融设置都值得细读。