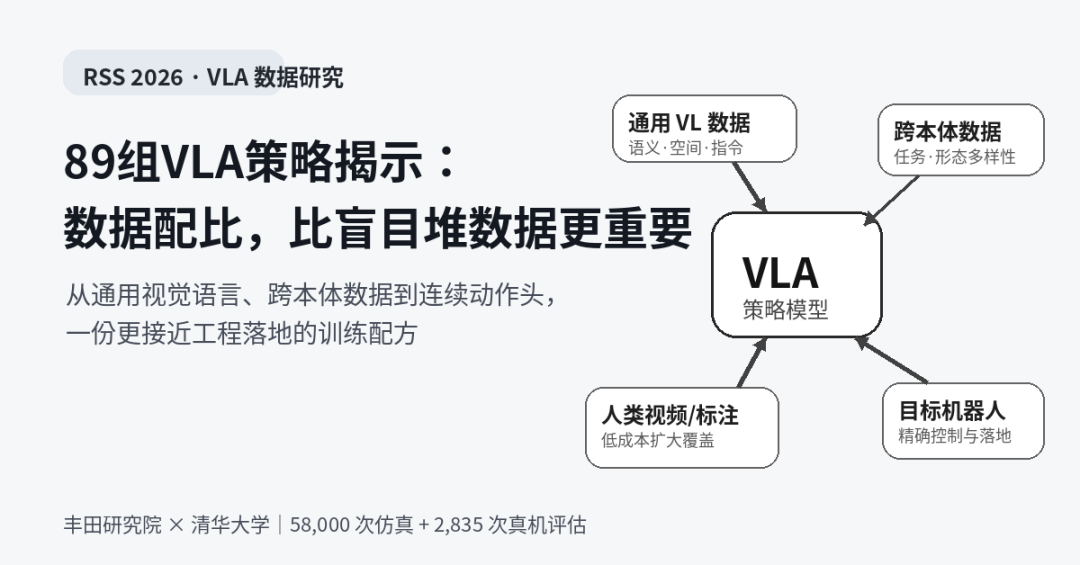
89组VLA实验之后,机器人行业该重新看待“百万小时数据”了
2026-09-22
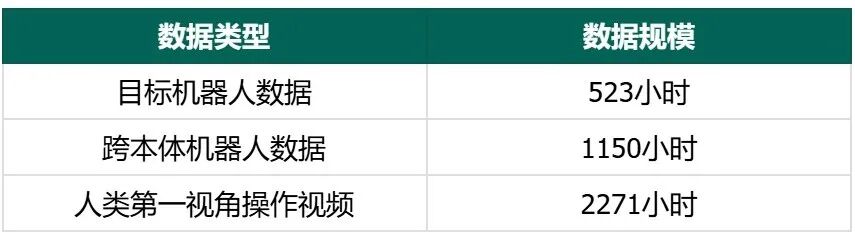
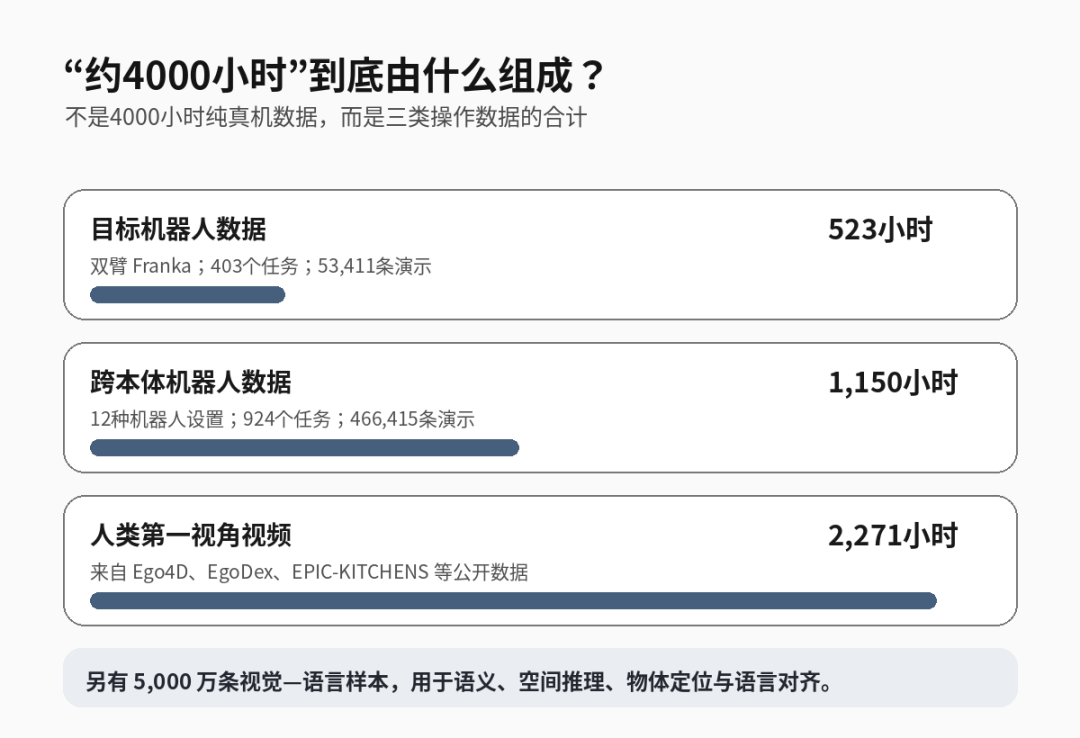
先看清“约4000小时”是怎么来的
为什么只用机器人轨迹,模型反而可能退步?
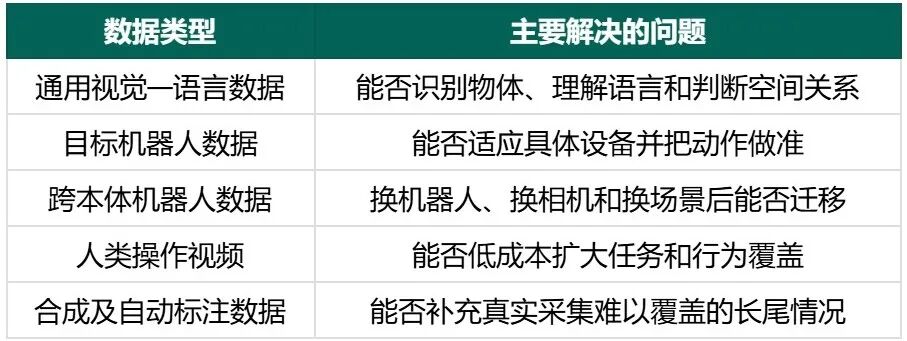
不同数据,到底分别解决什么问题?
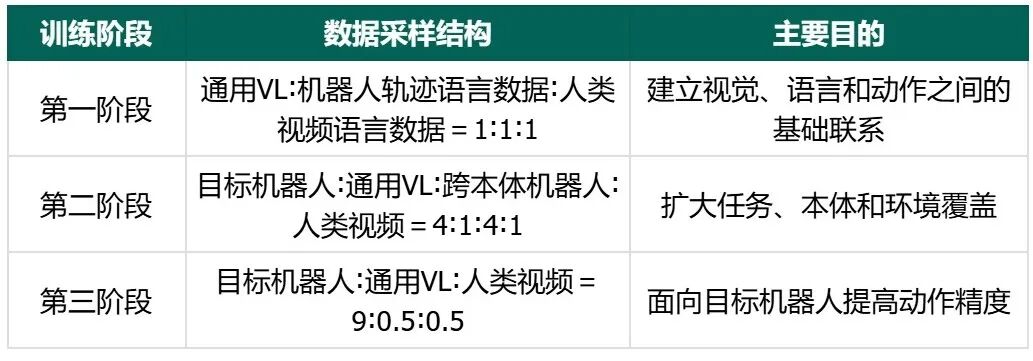
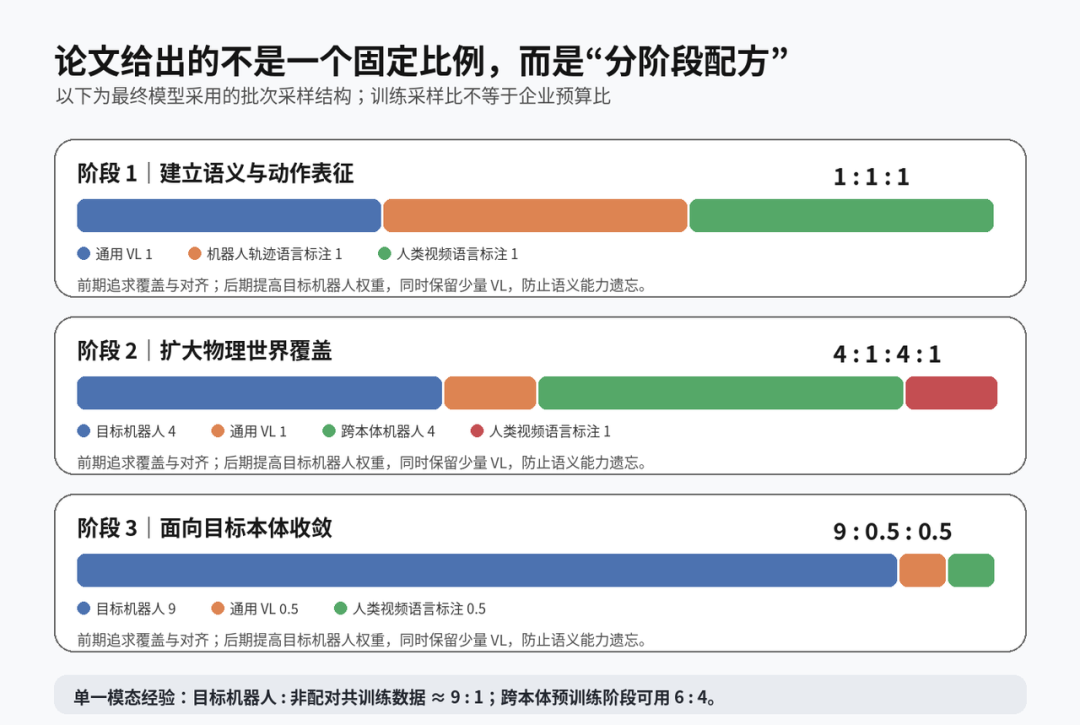
论文里的三阶段配比,应该怎么理解?
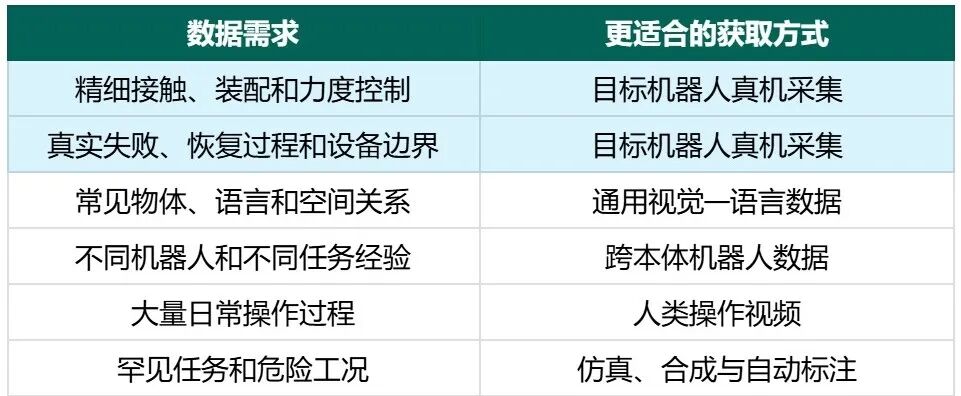
对企业最直接的影响:真机数据应该重点采什么?
离散动作token真的被证伪了吗?
数据规模仍然重要,但不能只看小时数
结语
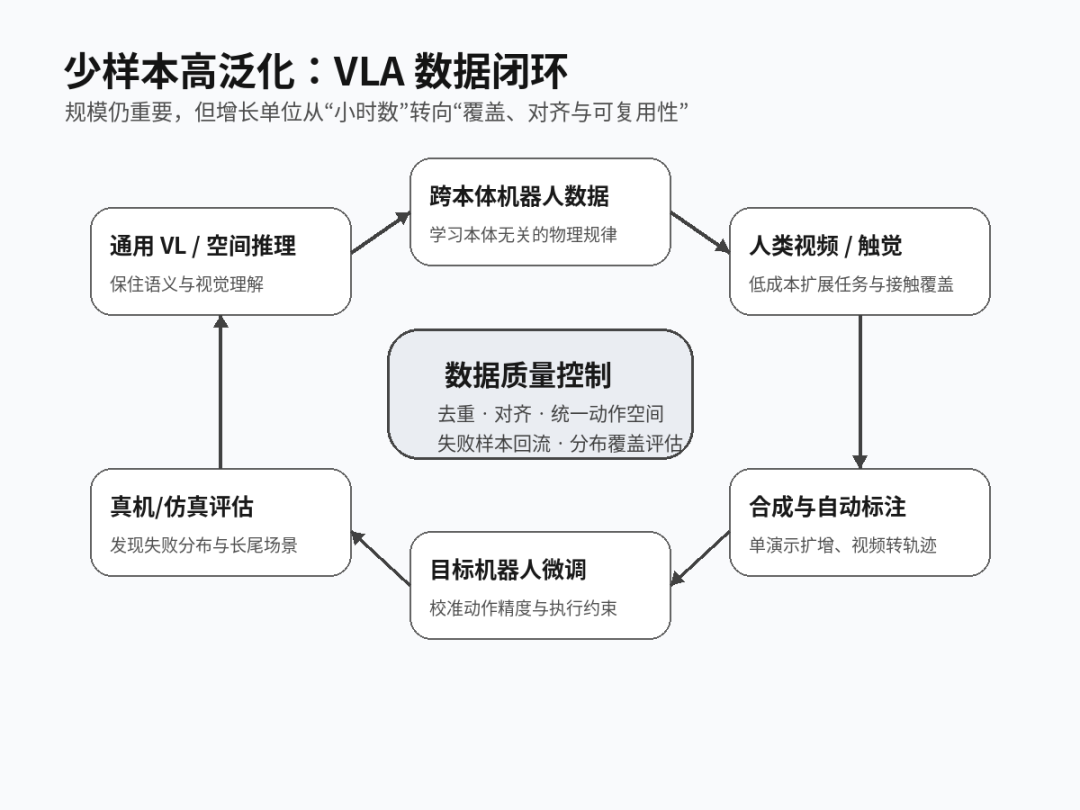
它给出的是一套更实用的数据分工方法:通用视觉—语言数据负责维持理解能力,跨本体数据负责扩大任务和设备覆盖,目标机器人数据负责提高控制精度,人类视频和合成数据负责补充任务多样性。
对机器人团队来说,真正需要回答的问题,不是今年还要再采多少小时,而是下一批数据准备解决什么问题。
在启动新一轮采集前,至少应该先问三件事:这批数据是否覆盖了新的任务和失败场景?这些知识能否从其他机器人、公开视频或视觉—语言数据中获得?训练完成后,准备通过什么评估证明这批数据确实有效?
VLA的数据竞争没有结束,只是评价标准正在变化。未来更重要的,不是谁积累的轨迹小时数最多,而是谁更清楚哪些数据值得采、应该在什么阶段使用,以及它最终改善了模型的哪一种能力。
下一篇:这是最后一篇
上一篇:这是第一篇