AI角色总像“假人”?80个表情提示词直接抄,让角色真的有演技

2026-09-18

先搞明白:AI的表情,为什么总是“假”

先说个背景知识,不深,三句话能讲完。
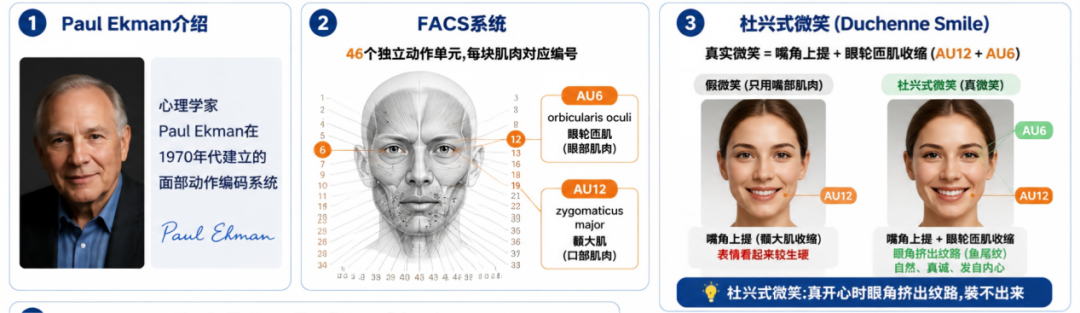
心理学家Paul Ekman在1970年代建了一套面部动作编码系统,叫FACS,把人的面部表情拆成46个独立的动作单元,每个单元对应一块或一组肌肉的收缩,眼轮匝肌、颧大肌这些都有编号。

图片

这套系统里最有名的一个结论是:嘴角上提(AU12)加上眼轮匝肌收缩(AU6),才是心理学界公认的“真实微笑”,叫杜兴式微笑。它装不出来,因为眼轮匝肌不受意志控制。
你试一下就知道了:对着镜子咧开嘴笑,眼睛是没变化的;只有真开心,眼角才会挤出纹路。
这就是AI表情发假的第一层原因。你写“开心地笑”,AI能从训练数据里找到一万个样本,但大部分都是那种嘴在笑、眼没笑的客套表情。模型不负责区分,它只知道你说了笑,就给你一个平均化的笑。
所以这根本不是提示词技巧的问题,是认知问题。先搞清楚人是怎么演真的,才能让AI演真。

写表情的底层公式:五个要素,缺一个都崩
很多教程会让你写情绪词,“他生气了”“她很伤心”,这在AI视频里基本没用。模型拿到“生气”两个字,只能给一个泛泛的、卡通化的愤怒。
我把好用的表情提示词拆了一遍,发现都能套进一个公式:
面部部位 + 变化方向 + 力度程度 + 时间节奏 + 负面规避
五个要素,缺任何一个,AI都可能自己发挥,一发挥就崩。
举一个例子,写“压抑的怒火”:
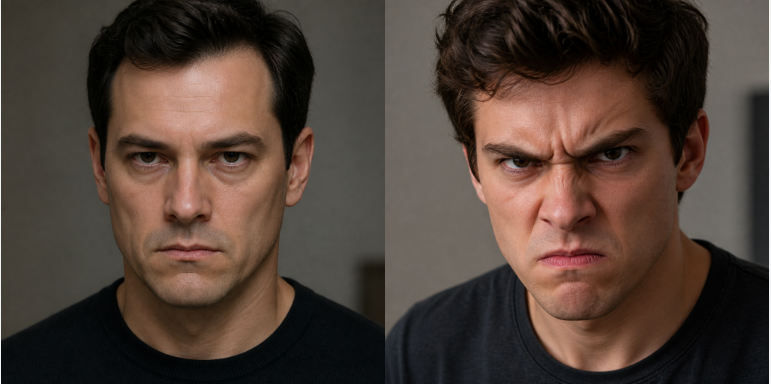
  • 部位和方向:降口角肌收缩,嘴角下压约3毫米;眼轮匝肌下半部收缩,下眼睑轻微上移;咬肌紧张,下颌线明显硬化。
  • 力度:咬肌的紧张程度,让下颌线看得出是绷着的。
  • 时间节奏:从第1秒开始持续,一直到对话结束,中间不松开。
  • 负面规避:无夸张皱眉、无咬牙切齿、无面部潮红。
同样是愤怒,这个写法和“他很生气”的差别,就是真人发火和表情包发火的差别。
第一遍写会觉得麻烦,写顺了其实很快,而且能反复用。

图片


把表情拆成时间窗口:AI懂帧,不懂“故事”
这是最容易被忽略的一步,也是决定成败的一步。
表情不是一张照片,是一个过程。从收到消息到忍不住笑,中间有半秒钟的没反应过来,再到嘴角翘起来,再到眼睛弯下去。这个过程才是人,才是戏。
但AI看到的不是过程,是帧。你不把过程拆开讲,它就默认给一个标准表情,从头演到尾。
正确的做法是:把一段表情拆成多个时间窗口,每个窗口2到4秒,独立描述。
比如写“绝望后冷静”:
  • 0到1秒:收到消息,先是愣住,眉头上挑又落下,嘴唇微张。
  • 1.2到5秒:眼睛移开,慢慢呼出一口气,肩膀下沉,嘴角轻轻抿了一下,然后彻底放松下来。
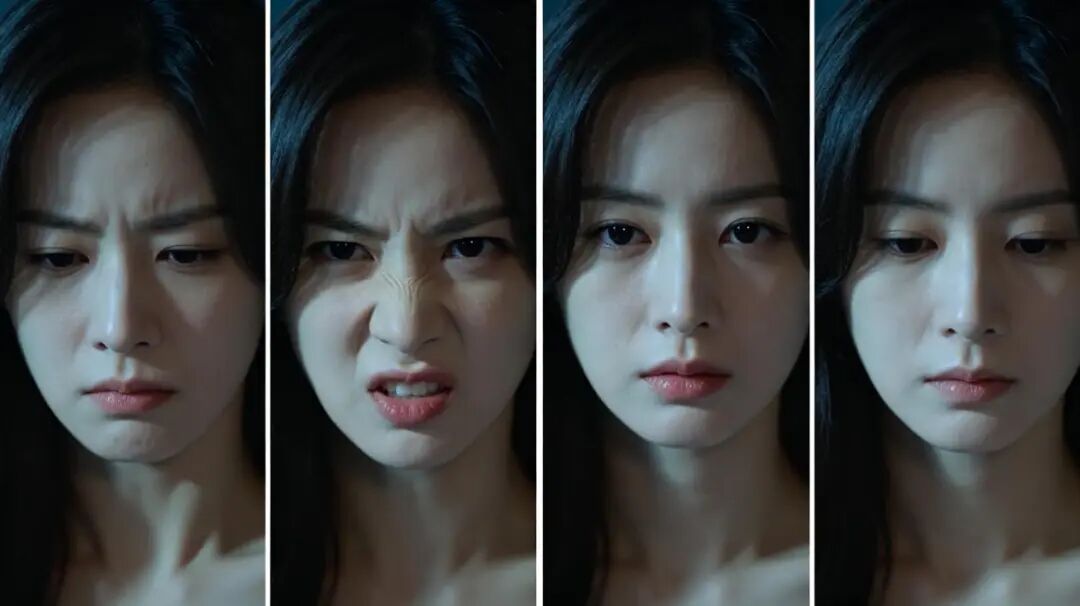
前1秒是崩溃的瞬间,后面几秒是收回去的过程。这种按秒拆解的写法,比一句“他绝望了”管用得多。
我自己试下来的感觉是,提示词里带时间节点,生成结果的可控性完全是两个档次。

图片


克制比爆发难写:两个小词,治“卡通脸”
AI最擅长的是爆发,瞪眼、张嘴、青筋暴起,因为训练数据里全是夸张表情。它最不擅长的是克制。
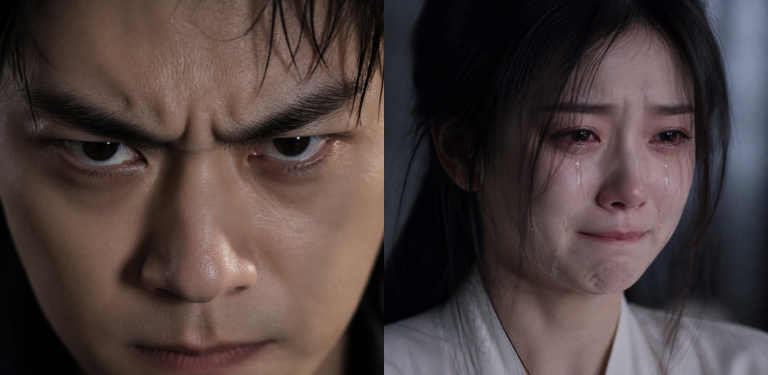
你写“他压抑着怒火”,模型大概率给你一个眉头紧锁的大特写;你写“她强忍眼泪”,它可能直接来个泪流满面。

图片

解决的办法很土:在提示词里加subtle、slight,微妙的、轻微的。这两个词能明显压住AI的卡通化倾向。
再配合负面规避,直接告诉它不要什么:
  • no exaggerated expression(不要夸张的表情)
  • no forced smile(不要硬挤出来的笑)
  • no cartoonish face(不要卡通化的脸)
正面给方向,负面给边界,两个一起写,模型就不太敢放飞。
有做过测试的朋友反馈,这类约束词对主流视频模型的效果提升挺明显,画面稳定性和表情准确度都能上一个台阶。建议自己也拿一个镜头对比一下,加和不加的区别很直观。

九类表情,80个现成提示词
下面这张清单可以直接抄,都是半年攒下来常用的。每个词都可以作为表情描述的起点,再按五要素公式补全。
  • 快乐类:开怀大笑、含蓄微笑、窃笑、得意坏笑、讨好笑、温柔笑、苦笑、欣慰笑、如释重负
  • 愤怒类:压抑的怒火、爆发大吼、怒极反笑、阴沉冷笑、不耐烦怒视、憋着一股火、咬牙切齿、冷淡
  • 悲伤类:啜泣、含泪强忍、低头落泪、失声痛哭、麻木、自嘲苦笑、失神、悔恨自责
  • 惊讶类:震惊、轻度意外、难以置信、惊喜、被吓一跳
  • 恐惧类:极度恐惧、不安、心虚躲闪、吓呆、后怕、胆怯、焦虑
  • 傲慢类:不屑冷笑、居高临下、轻蔑瞥视、鄙夷、轻佻调戏
  • 害羞类:低头脸红、慌乱躲闪、偷瞄、尴尬、不好意思
  • 困倦类:打哈欠、眼皮沉重、慵懒、无精打采
  • 宠溺类:温柔注视、慈爱笑、宠溺调侃、心疼、深情凝视
用的时候挑一个最贴近剧情的词,然后问自己三个问题:哪个部位在动?往哪个方向动?什么时候动?补完这三个,再想想要不要加一句负面规避。

别忘了眼神光:像素级的灵魂缺口
面部肌肉再准,眼睛是死的,角色照样假。
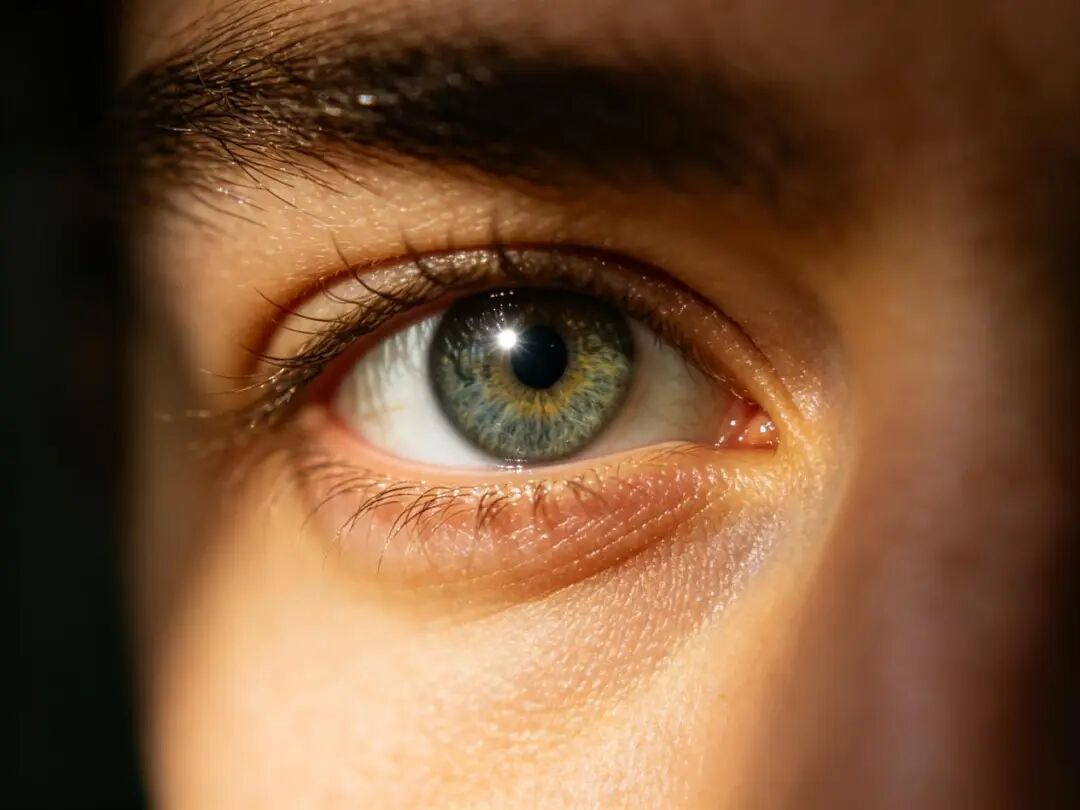
人眼对眼神极其敏感,我们看一个人,第一反应永远是看眼睛。AI生成的眼睛经常像一潭死水,瞳孔里没有高光,看久了会觉得这人不在场。
做法很简单:在提示词里明确写眼神光,英文写法一般就是加一个catchlight,或者直接描述瞳孔里的高光位置。
  • catchlight on the upper left of the pupil, soft and warm
  • 或者更简单:瞳孔左上方有一点柔和的暖色高光
别小看这一个高光点,它几乎是像人和像蜡像的分界线。

图片


三步,把表情做成自己的库
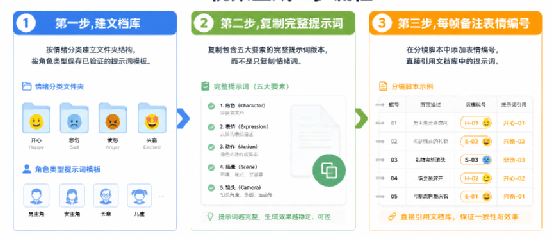
方法再好,不沉淀下来也是白搭。我现在的流程固定三步。

图片

  • 第一步,建文档库。按情绪大类建文件夹,把试出来的好提示词按角色分类存进去。
  • 第二步,复制完整提示词。每一条都是验证过的完整版,五要素齐活的那一版,不是只有情绪词。
  • 第三步,每帧备注表情编号。写分镜脚本时在画面描述旁加一列表情编号,直接引用库里对应的提示词。到生成环节不用临时想词,也不容易前后不一致。
这套流程第一次搭要花一两个小时,之后每一场戏都是复利。
说句掏心窝的话:
这套东西不神秘,也不需要你懂解剖学,它需要的只是耐心:写提示词、试镜头、存库、再试。我见过不少人试了两三次就放弃,转头继续写“他悲伤地看着镜头”。
AI视频这条路,卷到最后卷的不是谁的模型新,是谁愿意在没人注意的细节上多磨几遍。表情,就是那个细节。


分享
下一篇:这是最后一篇
上一篇:这是第一篇