武超则:AI产业本身并没有泡沫
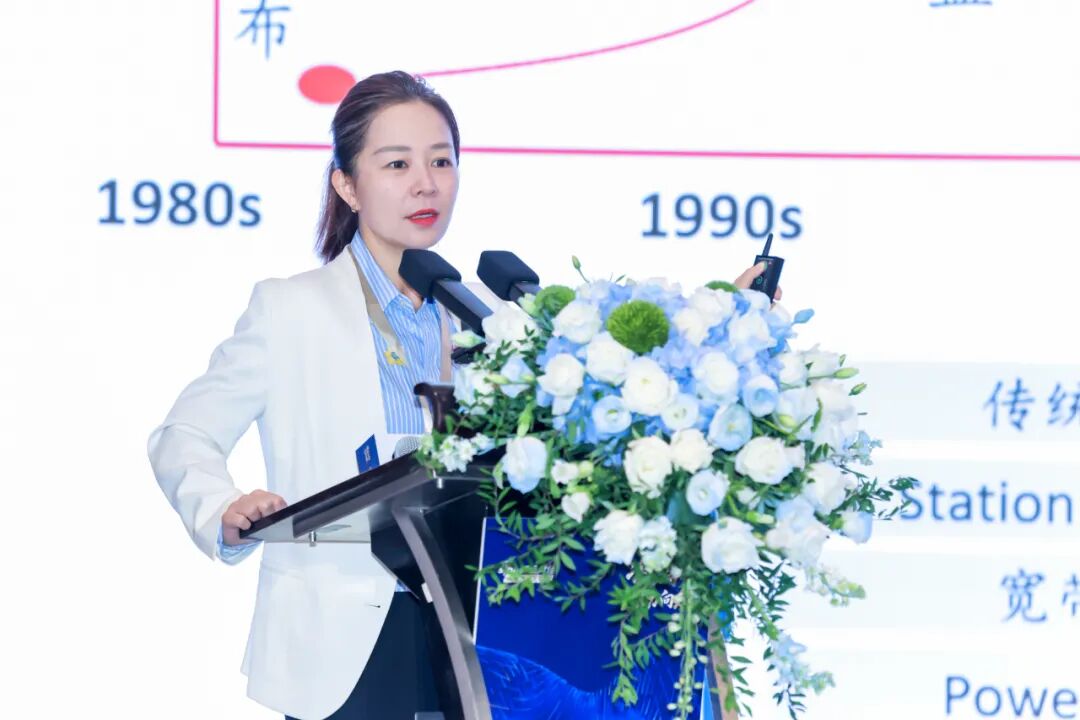
中信建投证券党委委员、执委会委员、未来产业和政策研究院院长 武超则
2. AI时代与上一个移动互联网时代存在显著不同。相似的是产业革命的量级,但不同的是资本开支的量级。在移动互联网那二十年,每年中美底层资本开支大概在1000亿美金左右;而今天谈人工智能,基本上是万亿美金——今年北美CSP厂商资本开支大概8000亿左右,中国也有一定规模,加起来大概就是每年万亿美金级别。十年前移动互联网资本开支的10倍量级,当然10倍资本开支背后可能带来10倍甚至更高预期的回报,但前提是要先把这10倍资本开支投下去,这是量级的不同。
3. 接下来,高的资本开支、高的预期回报、高的利率、高的中美资本开支差距补充,这件事情是非常确定的。
4. 第一阶段是2023年自然语言大模型,让机器像人一样能说会道,提供情绪价值;第二阶段是会工具,从能说变成能解决问题;第三阶段是所谓“DeepSeek时刻”,推理模型或规划决策模型、慢思考模型出现,大模型已经不是一个能说会道的简单助理,而是具备强大推理能力;下一代大模型迭代趋势是预测模型,比如AI for Science,涉及医疗、金融、科研等问题,这是下一代模型跃迁可以想象的。
5. 大模型最终是会平权的,不管是开源模型还是模型自身交叉迭代,应用的差别靠什么?谁有源源不断的第一手物理世界新增新鲜数据,现在所有AI用的实际上还是互联网或者说历史上存量数据,这就是为什么现在很多人要去做AI终端、做AI硬件、做AI机器人。
6. 传感器解决的是AI跟物理世界“最后一公里”,那个纽带非常重要。看好能够获得第一手物理数据做传感器、做AI终端的公司。
7. 全球AI竞争是很难停下来的,尽管发展过程中有很多安全问题、资本开支带来高债务问题等,但整体来看,大模型依然在高速迭代,它更像移动互联网时代的操作系统和引擎,所以中美头部模型依然值得投资。在这个过程中,只要模型不断迭代、不断Scale,算力需求仍然是非常确定的。今天的算力更多是一个耗材,而不是简单的一次性资本开支,国产化的主线未来几年可能增速更快。
8. 算力接下来更多机会向内看,模型本身更多机会向外看,因为模型目前在海外商业化场景或闭环是更快的。

武超则指出,回顾过去四五十年的ICT产业发展历程,大致可分为三个阶段:从80年代到2000年左右的PC互联网时代;从2000年到2018年约二十年的移动互联网时代;2018年之后进入数字化、智能化时代。每一个大的技术创新周期都有很多相似性,都是一个大的底层技术或以科技驱动的全要素生产率的大跃升,人工智能无疑是这二十年的主线引擎和核心生产力。
但她强调,AI时代与上一个移动互联网时代存在显著不同。相似的是产业革命的量级,但不相似的是资本开支的量级。在移动互联网那二十年,每年中美底层资本开支大概在1000亿美金左右;而今天谈人工智能,基本上是万亿美金——今年北美CSP厂商资本开支大概8000亿左右,中国也有一定规模,加起来大概就是每年万亿美金级别。十年前移动互联网资本开支的10倍量级,当然10倍资本开支背后可能带来10倍甚至更高预期的回报,但前提是要先把这10倍资本开支投下去,这是量级的不同。
更重要的是,十年前处于一个大的全球化时代,全球共享一个供应链或规模经济;但今天在逆全球化时代,中美科技竞争与科技革命同时发生。十年前不用考虑要不要投底层操作系统,当时就是iOS和Android,直接从互联网创业开始做;今天不仅要谈怎么做大模型、做智能化时代的操作系统,还要谈怎么基于大模型解决上层的算力问题、芯片问题、芯片上层先进制程问题、半导体设备材料问题。所以除了10倍于自身产业革命特征所带来的资本开支,还要解决两套供应链的问题,直观来看投资规模可能就是上一轮的20倍或者更高。
武超则认为,从这个视角来看,接下来高的资本开支、高的预期回报、高的利率、高的中美资本开支差距补充,这件事情是非常确定的。
武超则从ChatGPT出来到今天模型不断迭代的过程中,总结出四个大的阶段:第一阶段是2023年自然语言大模型,让机器像人一样能说会道,提供情绪价值;第二阶段是会工具,从能说变成能解决问题;第三阶段是所谓“DeepSeek时刻”,推理模型或规划决策模型、慢思考模型出现,大模型已经不是一个能说会道的简单助理,而是具备强大推理能力;下一代模型迭代趋势是预测模型,比如AI for Science,涉及医疗、金融、科研等问题,这是下一代模型跃迁可以想象的。
她表示,从短短三四年时间来看,人工智能大模型的延展自我迭代变革速度是非常快的,某种意义上用“超预期”来形容并不为过。从产业角度,她一直坚持一个观点:并没有所谓的泡沫,更多的泡沫来自于底层巨大的资本开支和今天看到的商业模式闭环之间的鸿沟,而不是模型或人工智能本身发展进程中它的能力。只要看到模型能力还在不断延展,大家处在高速竞争状态下,这件事情是很难倒退回去的。
武超则将AI产业链分为三个大部分:算力、模型、应用。算力再拆分为海外链和国产链;大模型分为基础大模型、多模态、机器人及自动驾驶;应用端分为C端和B端。
武超则指出,北美和日韩的主要强项是在计算环节,包括GPU、CPU、存储和代工等,占到产业链价值量的70%,中国产业链强项在传输和电源等领域,比如光模块、连接器和PCB等领域,占产业链价值量的约30%。但移动互联网时代,以手机产业链为例,中国供应链能分到的更少,远远达不到30%。但更重要的是未来——中国在这些供应链板块已经做得非常成熟之后,到底哪些环节有可能走到那高价值量、高壁垒和高毛利的70%里面去?在国产化主线上,产业变革窗口期、巨大市场以及产品能力提升正在同时发生,能够完成国产替代或全球份额竞争的有核心技术的科技企业,这是接下来投资上最主要的主线和机会。
她举例说明:GPU环节,全球龙头是英伟达、AMD,中国对应的有海光、寒武纪、华为等企业,但目前全球占比还非常低;存储方面,海力士占全球90%以上的份额,长鑫存储7%以上的份额,未来解决的问题是怎么从7%做到更高;通信和传输领域中国已经在全球份额比较高,更多是要关注新产品和技术迭代能力和产业链上游芯片的自研;PCB、供电领域也是类似的。
武超则强调,未来最好的企业或最好的产业链,是要思考中国在这些供应链中,哪些环节有能力走到那高价值量的70%里面去。现在大模型的定价、硬件竞争、定价和估值都是全球定价,投资人会看你在全球这个产业链和环节处在什么位置来给估值。所以未来科技龙头一定是在全球竞争下有比较优势的。
武超则将AI应用看成两个大的象限:复杂场景和容错率。
她指出,第一阶段已经走向现实或闭环的AI应用,场景不是很复杂且容错率比较高,比如AI搜索、AI编程以及办公软件等。下一阶段目前正在发生的,AI应用做得比较好的是复杂程度比较高、容错率也比较高的象限,比如视频生成、游戏开发,这是多模态的东西,对容错率要求不高,是目前国产模型商业化做得比较好且产业渗透率比较高的部分。后续更多就是场景简单但容错率低的部分,比如AI金融、法律和教育等。最终就是高复杂且高可靠的领域,如具身智能、无人驾驶、AI科研等领域。
武超则最后总结称,全球AI竞争是很难停下来的,尽管发展过程中有很多安全问题、资本开支带来高债务问题等,但整体来看,大模型依然在高速迭代,它更像移动互联网时代的操作系统和引擎,所以中美头部模型依然值得投资。另外在这个过程中,只要模型不断迭代、不断Scale,算力需求仍然是非常确定的。今天的算力更多是一个耗材,而不是简单的一次性资本开支,国产化的主线未来几年可能增速更快。
她提出,算力接下来更多机会向内看,模型本身更多机会向外看,因为模型目前在海外商业化场景或闭环是更快的。她认为,大模型最终是会平权的,不管是开源模型还是模型自身交叉迭代,未来靠的是谁有源源不断的第一手物理世界新增新鲜数据。
“现在所有AI用的实际上还是互联网或历史上存量数据,这就是为什么很多人要去做AI终端、做AI硬件、做AI机器人,更多要的是那个传感器,那个传感器解决的是AI跟物理世界最后一公里的纽带,非常重要。我们非常看好能够获得第一手物理数据做传感器、做AI的公司。”武超则说。
武超则认为,AI产业现在发展的位置更像移动互联网的2013年、2014年,模型高速迭代、算力大幅扩容但依旧供不应求、应用方兴未艾。目前在应用快速变化的赛道里很难买到确定性的,但毫无疑问,它会容纳更多的创新、更多的创意和更多的公司。在未来一段时间随着模型算力分化之后,这个部分的变化也是最多的,是值得去持续跟踪的。