数字人技术新突破!港中文开源Ex-Omni-2D,一体化生成文本、人声、动态视频,告别拼接卡顿。
2026-09-16
AI能听懂、能说话,但你看不见它——这种“隐身”的对话体验,正在被港中深团队打破。Ex-Omni-2D让全模态对话模型拥有了属于自己的数字人形象。
全模态对话模型近年来取得了飞速进展,能够理解语音、文本和视觉输入并生成自然的语音回复。然而,一个根本性问题始终存在:语音回复在视觉上是“缺席”的——用户听到声音,却看不到一个与之对话的、具有外观、情感和动作的具身化Agent。现有的说话数字人模型虽然能生成高质量的视频,但其视觉行为通常由完整的语音波形和外部手动准备的提示驱动,而非从对话状态中自然涌现。
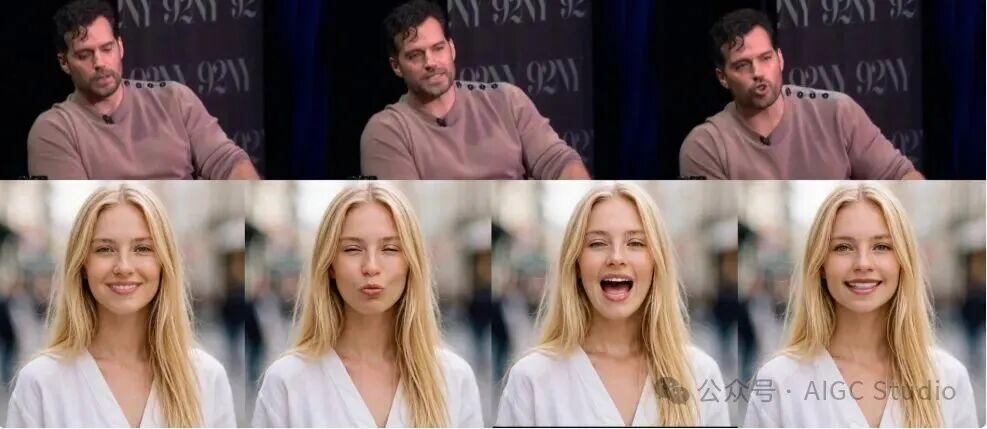
香港中文大学(深圳)与LIGHTSPEED联合提出的Ex-Omni-2D,从“对话原生视频响应”的视角切入,通过结构化视觉思维规划(VTP)和多码本语音单元共享接口,首次让全模态对话模型在生成文本和个性化语音的同时,输出与对话内容同步的数字人视频。更关键的是,通过Prefix Streaming蒸馏技术,该方法在4步推理下实现了端到端实时因子1.293的流式生成能力。代码、模型权重和在线Demo均已全面开源。
下一篇:这是最后一篇
上一篇:这是第一篇