数据要素的“反直觉”真相:不流通,才是最大的浪费!结合京政发〔2026〕15号文件里数据要素部分:释放的前提是什么?是被用掉
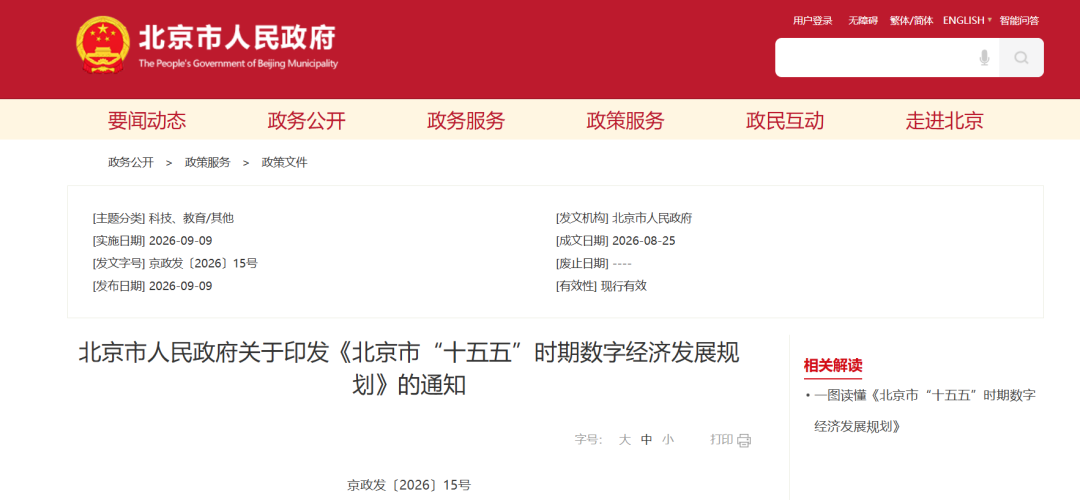
2026年8月25日,京政发〔2026〕15号文件成文。9月9日,全文公开。
《北京市“十五五”时期数字经济发展规划》落地。
规划定了:
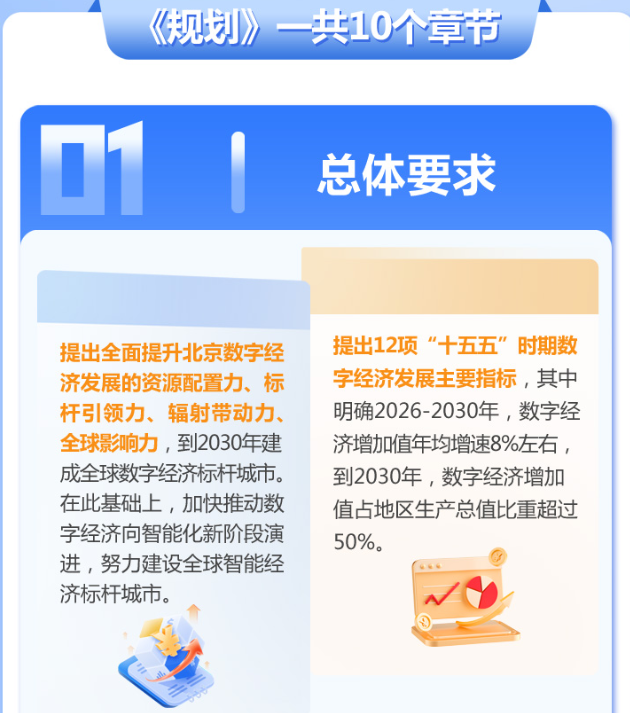
12项主要指标,到2030年数字经济增加值占GDP比重要突破50%,公共数据开放平台开放数据量要达到17亿条。
但今天不聊这些。
聊一个被大多数人忽略的细节。
规划在数据要素层面的表述,用的词是“价值潜力充分释放”。
注意,不是“规模突破”,不是“交易额翻番”,是“释放”。
释放的前提是什么?是被用掉。
这个逻辑,在当下的数据要素讨论中,恰恰是被绕过去的。
截至2026年5月,A股5000余家上市公司中,只有134家披露了数据资源入表事项,占比不足3%,合计金额38.6亿元。
同期,北京国际大数据交易所累计发放数据资产登记证书1036个。上架产品3310个,场内交易规模2.16亿元,备案交易规模172.93亿元。
备案交易是场内交易的80倍。
翻译一下:大量数据交易发生在场外。
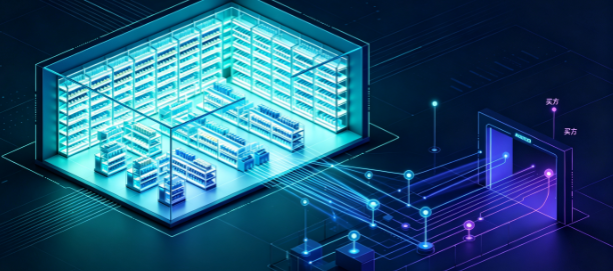
场内的“超市”货架摆得整整齐齐,但买卖双方选择在门口私下成交。
这不只是一个地方独有的问题。
复旦大学一项针对全国“场内”数据交易机构的研究发现,各地数据交易所实际运营成效普遍不佳,在缺少真实交易量的情况下,部分机构通过“搬运”“凑数”来制造交易量。
数据要素市场最尴尬的现实是:制度框架搭得比市场本身跑得快。
大多数地方谈数据要素,先谈确权、再谈交易、最后谈入表。
顺着“确权—定价—交易—入表”的线性逻辑走。
北京的做法是把这个顺序反过来。
7月3日,2026全球数字经济大会数据要素发展论坛上,北京数据集团旗下京算公司发布了北京首家国资“词元工厂”——京算Token工厂。
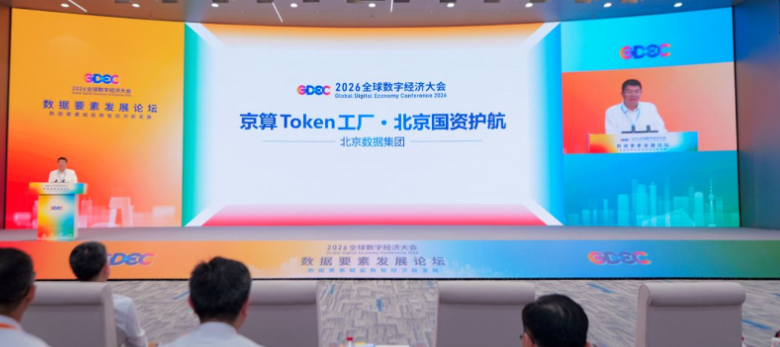
半个月后,北京经开区出台全市首个“词元经济”专项政策,每年发放1亿元模型券或词元券,企业按词元消耗费用的50%申请补贴,最高500万元。
逻辑很清晰:先让数据被用起来,再谈其他。
词元是大模型处理信息的最小单元,具有可计量、可定价、可交易的特征。
北京不是在等数据确权制度完善后再推动流通,而是通过词元这个“计量单位”,让数据在使用过程中自然产生定价信号。
这和《北京市公共数据资源授权运营管理办法》的思路一脉相承。
该办法规定,公共数据用于公共治理和公益场景的,有条件无偿使用;用于产业发展的,实行政府指导价。
收益分配遵循“谁投入、谁贡献、谁受益”原则。
先让数据流动起来产生价值,再在流动中解决分配问题。这个顺序,很关键。
数据要素有一个容易被忽略的属性:它和土地、劳动力、资本不一样。
土地放着不会贬值,劳动力闲着只是浪费,资本躺着还有利息。
但数据不动,就是在消耗存储成本、维护成本、合规成本。
IDC做过测算,全球数据量每两年翻一番,但被分析利用的比例长期不足2%。
未被使用的数据,本质上是企业的负债。
北京“十五五”规划中有一个容易被忽略的指标——单位电力生成词元数量,从2025年的500提升到2030年的2000。
这个指标的意思是:
同样的算力消耗,要产出更多可用的数据产品。
数据基础设施的效率,直接决定了数据能不能被“消耗”掉。
再看一组数据。
全国累计建成高质量数据集超过12.6万个,数据总体量超过1815PB,较2026年3月增长超过89%。
供给端在快速膨胀。如果消费端跟不上,就是新一轮的产能过剩——只不过这次过剩的是数据。
规划文本里有一段话值得细读:
“健全数据产权、收益分配等基础制度,做强北京国际大数据交易所,建设数据产业集聚区与高端标注基地。”
产权和分配,是横在数据要素面前的两座山。
《光明日报》6月的一篇文章点得很透:数据确权长期依赖经验判断,削弱了制度的可执行性,大量数据资源因此长期沉淀,难以转化为现实生产力。
更关键的是收益分配。
头部平台凭借技术优势和流量入口主导收益分配规则,原始数据供给方、中小加工服务方难以得到合理回报。
一个真实案例:
在医疗数据领域,高血压等常见病诊疗数据存量充沛、获取门槛低,科研附加值有限,数据以“条目”为单位计价,价值差异无法在收益中体现,稀缺优质数据供给方收益与贡献严重错配。
“条目”计价掩盖了数据质量的差异。
北数所2月完成的“一登双证”——同时颁发数据产权登记证书和数据资产登记证书——就是让数据在确权和资产化之间建立直接通道。
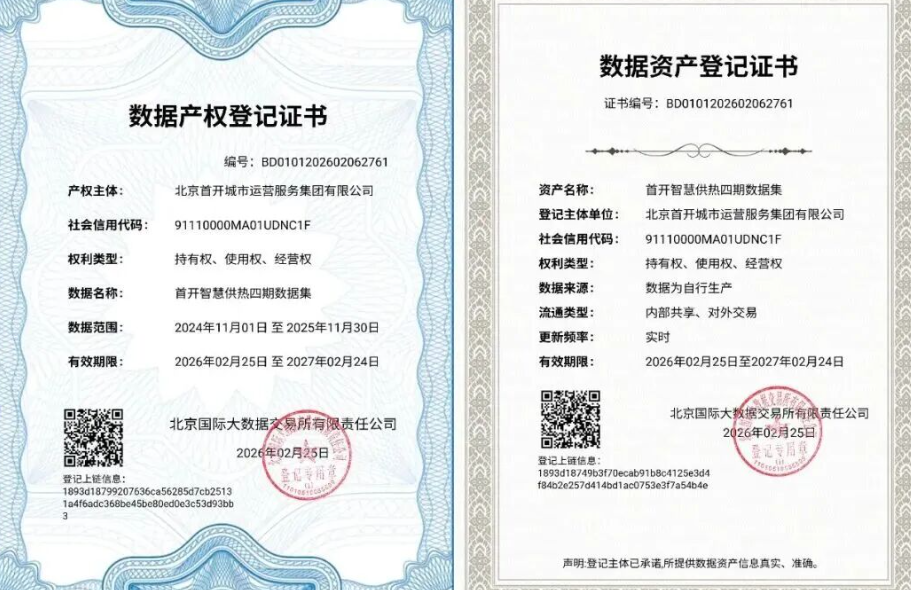
不走完所有流程再交易,而是在交易中完成确权。
跨区域这一步,比很多人想的重要
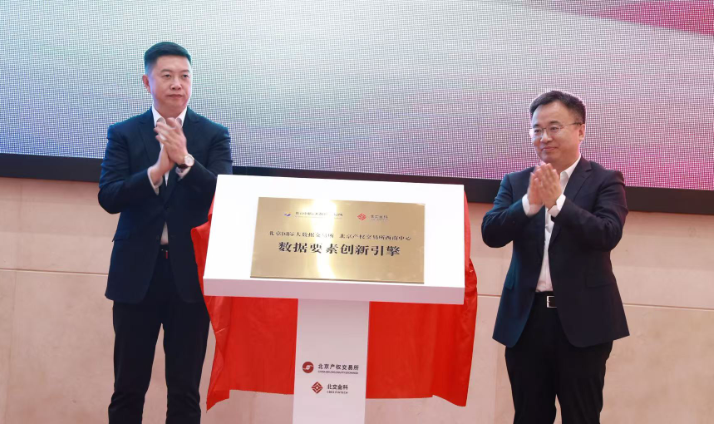
5月,北京产权交易所与北京数据集团共同启动“数据要素创新引擎”,打通北京与西南地区数据要素跨区域流通通道。
“十五五”规划纲要首次提出“建设开放共享安全的全国一体化数据市场”。
国家数据局2026年工作要点中,“深化数据要素市场化配置改革”被列为八项重点任务之首,核心任务之一就是“加快建立全国统一数据产权登记制度”。
全国统一的数据产权登记制度,前提是各地愿意把数据拿出来跨区域流通。
如果每个地方都把自己的数据捂在口袋里,全国一体化就是一句空话。
回到规划本身
“十五五”数字经济规划的核心指标里,数字经济增加值年均增速目标定在8%左右。
到2030年,数智技术要对经济发展产生“放大、叠加、倍增”作用。
这三个词不是随便写的。
放大是量的扩展,叠加是质的提升,倍增是模式的变革。而这三个作用的共同前提,是数据要素真正进入生产函数。
数据要素在于:它越被使用,价值越大;越被囤积,价值越小。
这和传统要素的逻辑完全相反。
北京“十五五”规划的取向已经很明确——不是在数据确权的理论问题上继续打转,而是通过词元工厂、公共数据“先创新再授权”、跨区域流通引擎等机制,让数据在流动中被消耗、在消耗中产生价值、在价值中倒逼确权和分配的完善。
不追求完美的制度设计,而是在行动中迭代制度。